Maya: optimizing deep learning training workloads using GPU runtime emulation
佐治亚理工与NVI合作做的工作。值得注意的是,这篇论文的最后一位作者Alexey Tumanov是SAIL实验室负责人,即发表Ray的工作,相关的仿真工作则有Revati,2026预印本。倒数第二位作责Srinivas Sridharan则是ASTRA-sim的同一位作者。Amey Agrawal共同第一作者第二位还发表了Vidur(MLSys’24 LLM推理模拟)。
| 项目 | 内容 |
|---|---|
| 论文标题 | Maya: optimizing deep learning training workloads using GPU runtime emulation |
| 发表于 | EuroSys 2026 |
| 核心一句话 | Maya通过GPU运行时仿真技术直接模拟未修改的深度学习训练工作负载,消除了传统性能建模系统中的语义鸿沟,能够以极低开销实现对大规模分布式训练配置的高保真性能预测与部署优化。 |
| 适用场景 | GPU仿真、机器学习负载仿真 |
| 代码/项目 | Maya paper 代码未开源 |
Intro. to Idea
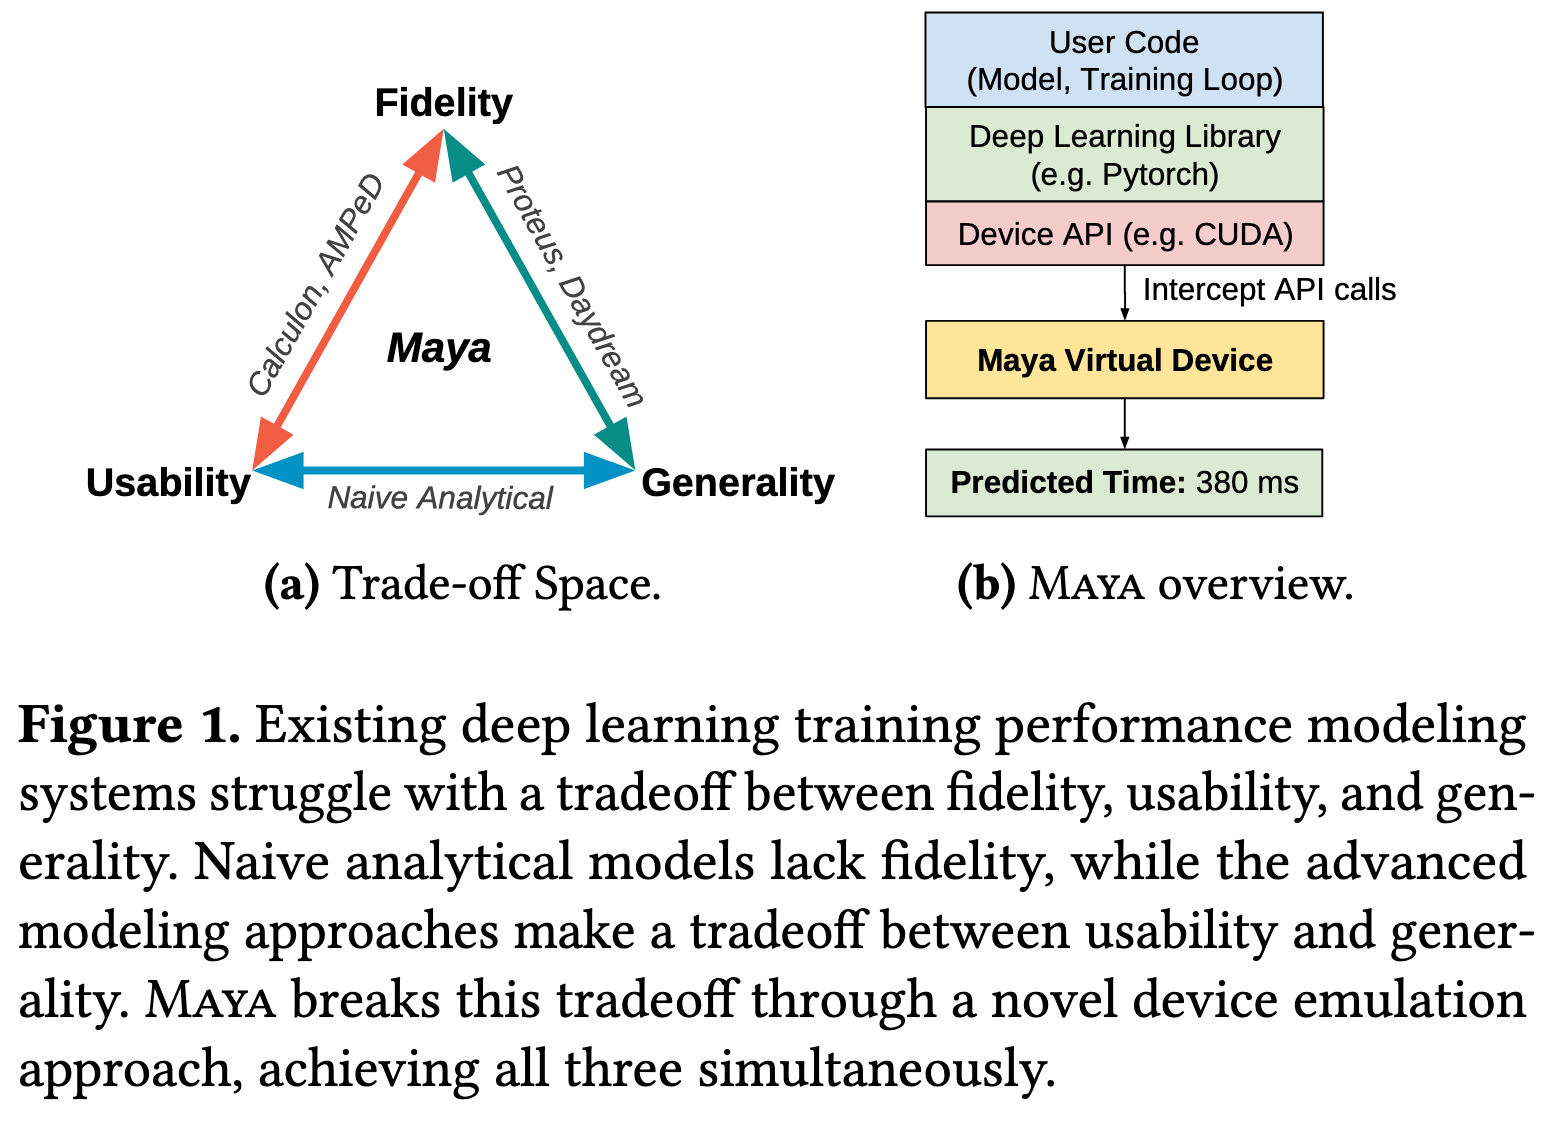
- Fidelity-Usability:Calculus、AMPed,这些工作采用解析式模型,用户只填声明式配置。对于解析式模型而言,针对任意新软硬件的特性就需要人为的显示推导。
解析式模型(analytical model) 指人工推导的数学公式直接计算性能,而不是真正”跑”一遍执行过程。
- Fidelity–Generality:Proteus、DayDream,这些工作采用传统四阶段建模路线:工作负载规格化、kernel分解、kernel耗时预测、分布式执行模拟。他们的区别在于怎么拿到“工作负载的表示”,对于复杂优化策略需要纯人工(Agent)编码。
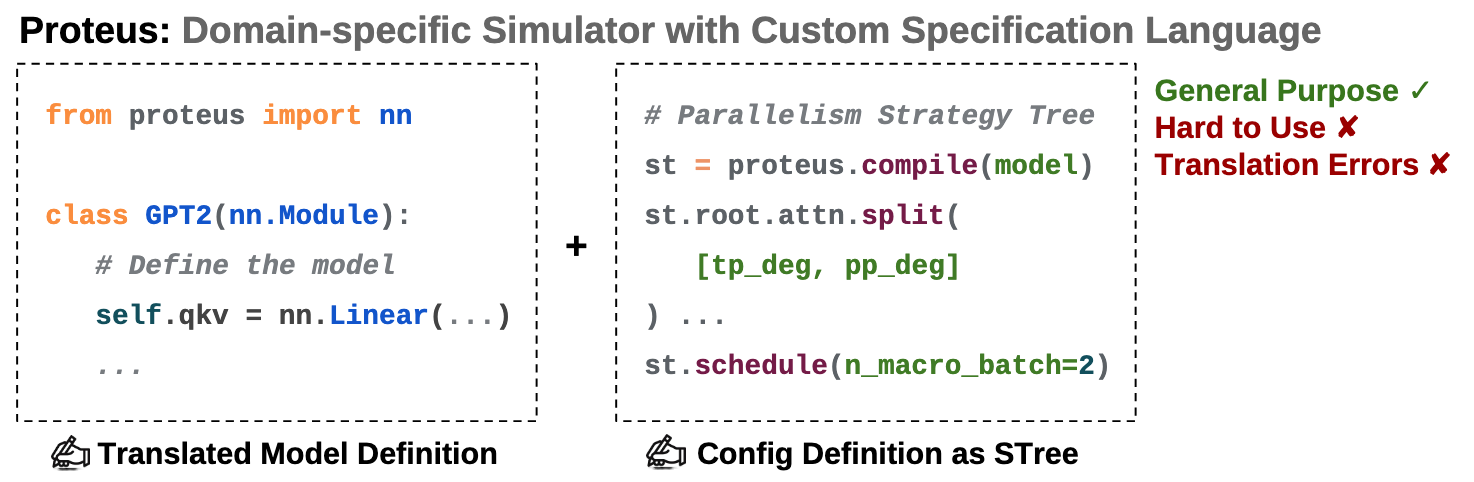
- Proteus:Strategy Tree IR + 手工变换
对于这个工作,其核心抽象是策略树,一颗覆盖整个模型的中间表示(IR):
- 用户先用 Proteus 自己的
proteus.nn模块重新定义模型(Fig 3 中间的代码示例),proteus.compile(model)生成初始策略树;
- 树中的节点对应算子/张量,然后用户显式调用变换操作把并行策略”刻”进树里,比如
st.root.attn.split([tp_deg, pp_deg])表示对 attention 算子做 TP/PP 切分,st.schedule(n_macro_batch=2)指定流水线调度;- 展开后的树经 kernel 分解得到执行图,kernel 耗时用真实 GPU profiling 获得(这是它保真度高的原因之一,Maya §7.2 特别提到 Proteus 是唯一在真卡上显式测 kernel 时间的基线);
- 最后做分布式执行的离散事件模拟。
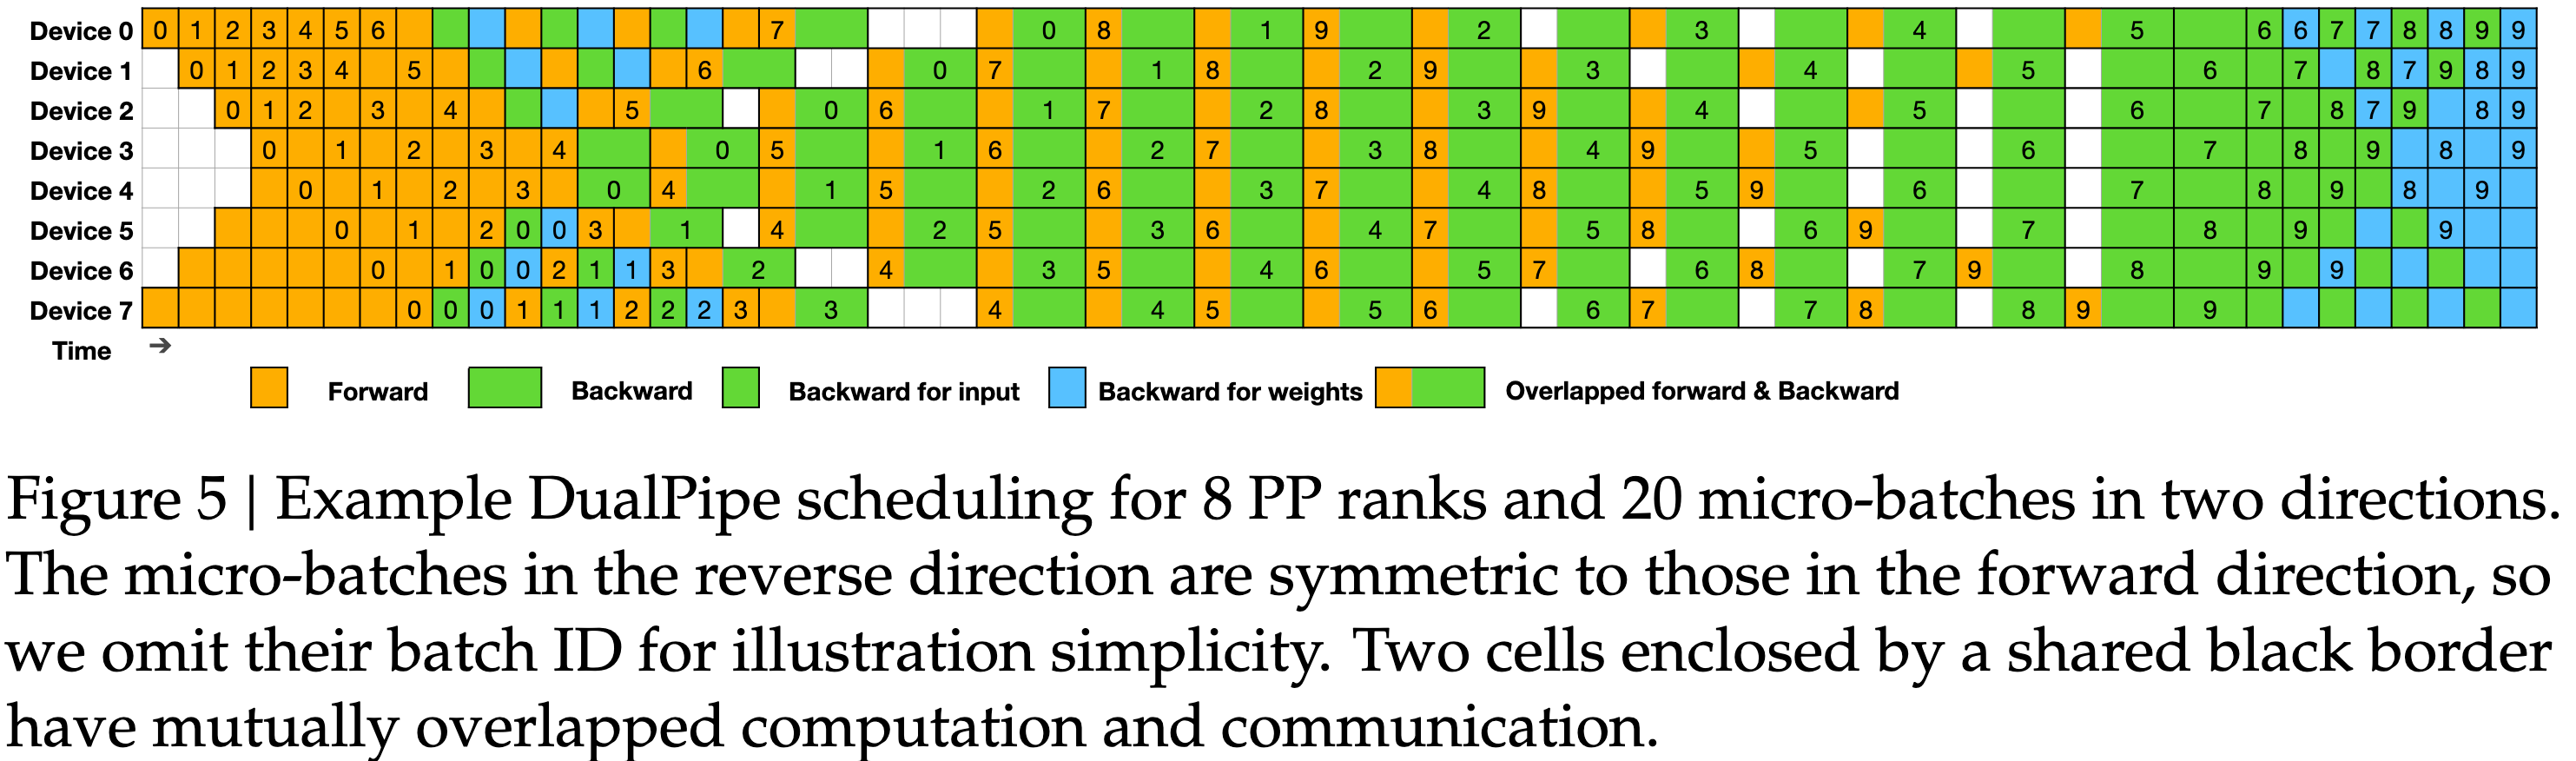
该工作的主要优势在于表达能力强:STree原则上可以任意编码切人,通信拓扑优化、显存优化组合。代价是Usability,其在GPT3的仿真任务中需数百行专用代码,Deepseek的DualPiple则需要一个自定义的图变化pass。
针对这里图变化pass有如下解释:
这里对两个不同的执行子图需要进行共享GPU的编排。这里ds3在这里的执行顺序是有较严格的指定的。
这要求仿真工作需要大量的代码与对仿真workload深刻准确的洞察。
- Daydream:真实 trace + 人工图变换
这个工作基于真实trace的采集,使用人工编写的图变换规则模拟优化。
例如:
- kernel fusion:直接融合节点并统计融合后耗时
- activation recomputation:把前向子图复制一份插入方向阶段对应位置,同时删掉激活存储带来的读写节点
- 流水线:把图复制并切分到多个虚拟设备上,插入通信节点。通信耗时用测量的集合通信或带宽模型估计
规则变化后,可能trace中并没有对应规则的kernel,daydream通过假设kernel耗时随工作量线性增加的规则外推仿真时间
- Usability–Generality:直接通过硬件能力与计算任务估算任务进行时间
右侧这张图中的maya virtual充当的是驱动与设备的功能。通过仿真给出预测的工作负载的时间。值得注意的是,这里的仿真运行是完全CPU运行的,因此相对于原负载需要运行精确的情况下,需要做运行时间上的取舍。在这篇论文中似乎不怎么考虑这一点。我的观点是如果仿真的运行时间超出原负载的运行时间,那么怎么保证其在搜索配置时比直接运行原负载更有效呢?或许在evolution部分会给出部分解释。
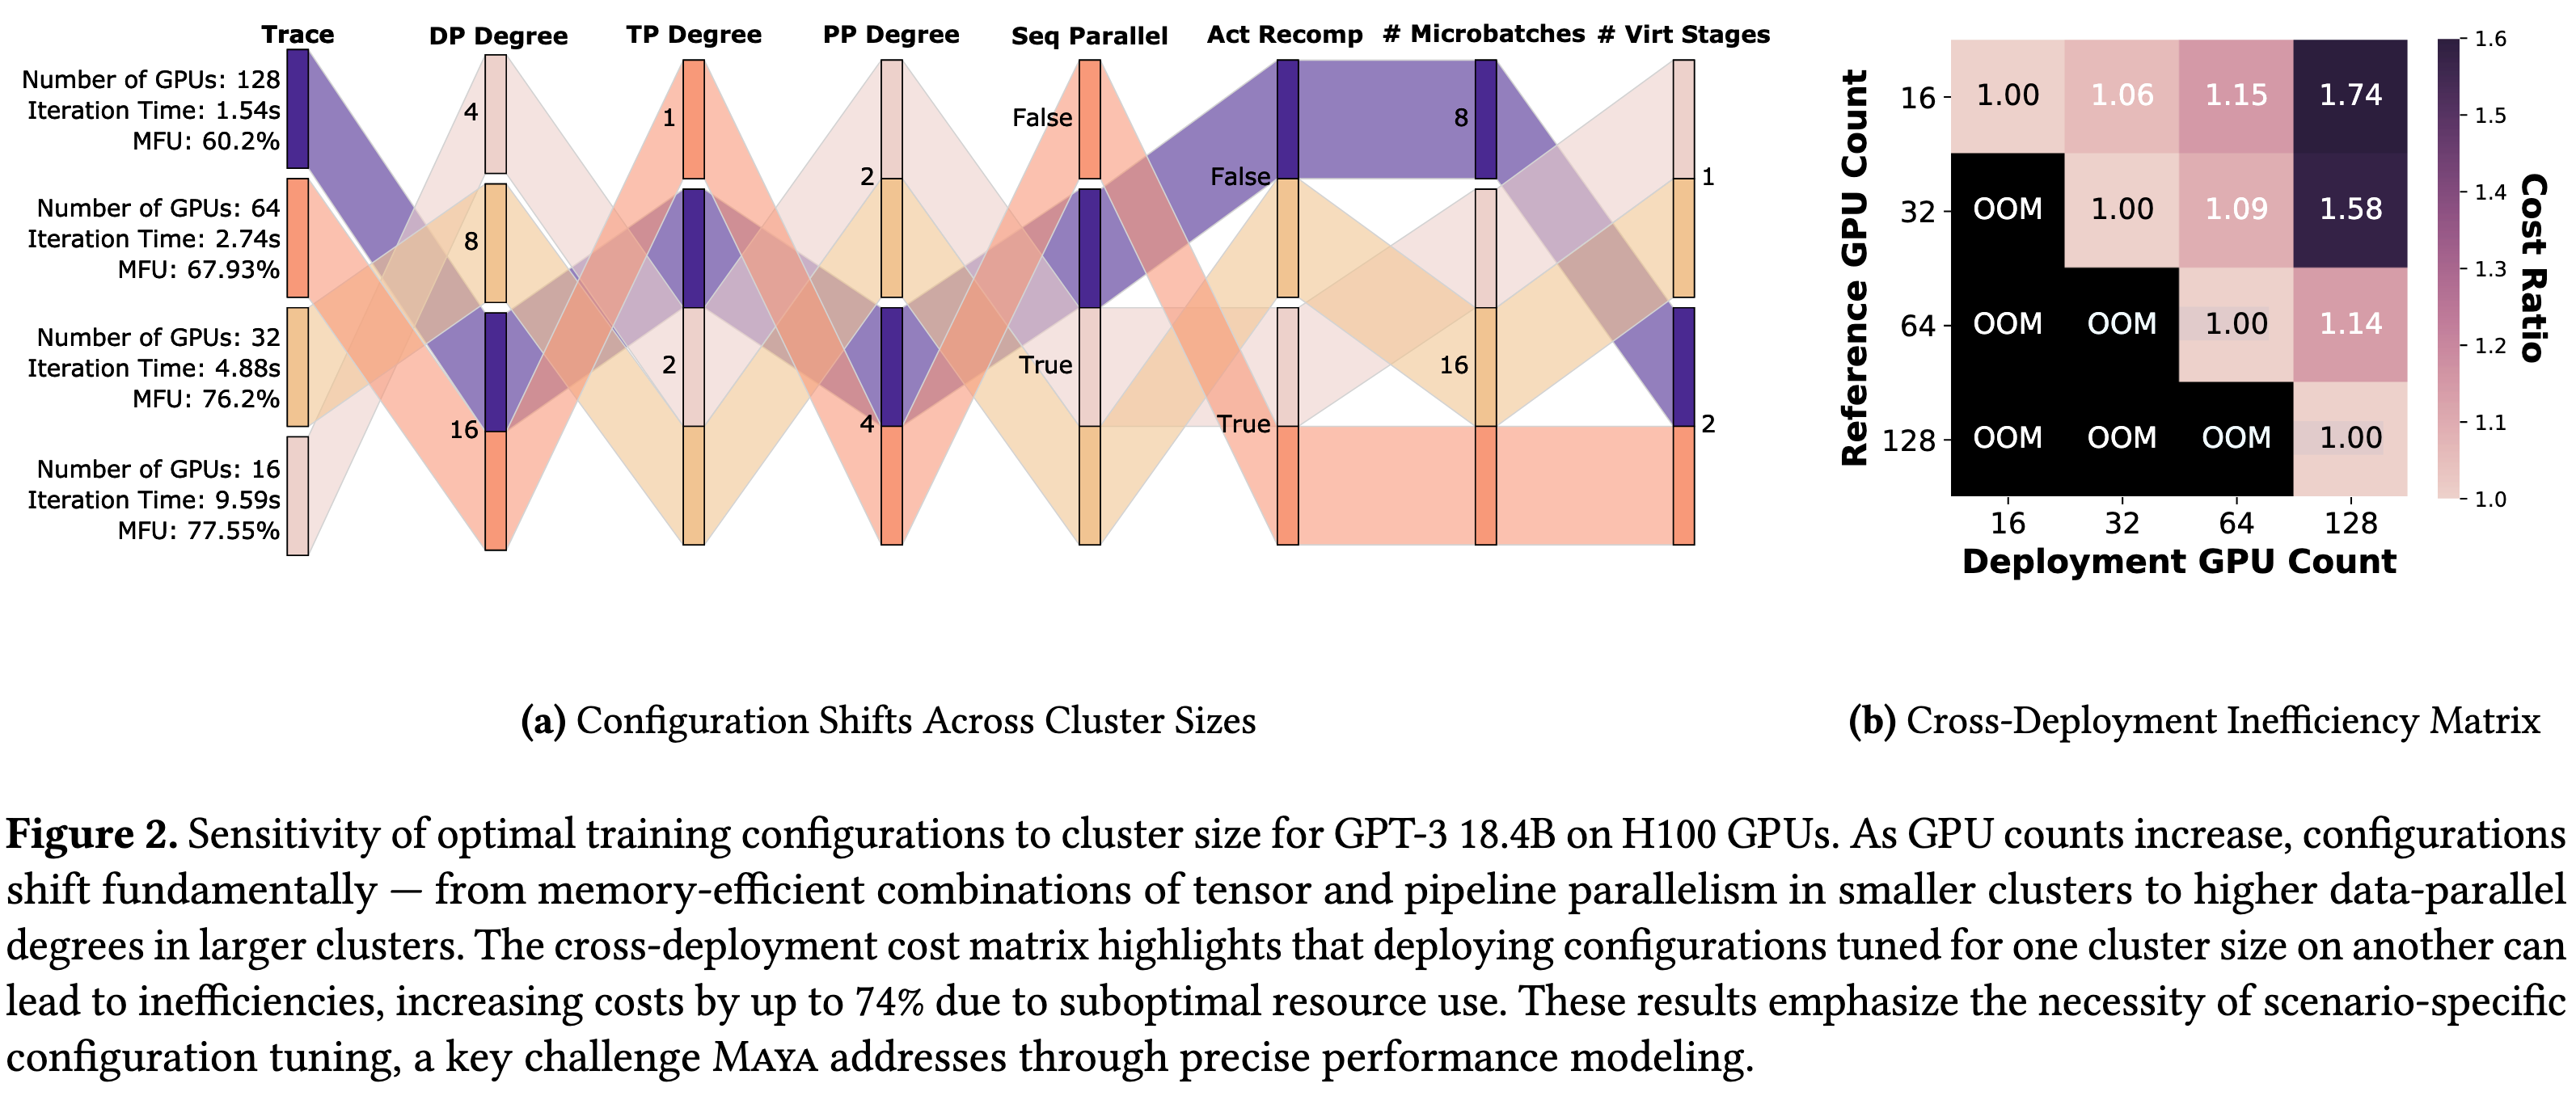
对于这张图而言,其展示了不同GPUs下的配置漂移以及对特定GPUs参考配置下的成本估算。可见,小规模Cluster的scale无法单调修改配置(例如增大DP等)可以理解,毕竟少量时可能需要增加新的层级,但从32->128GPUs观察到仍然不是单调的,在act recomp、Seq Parallel等配置上可以观察到,128GPUs甚至与32近似而不是64。同时,我们可以观察到Cost Hot Map中,确实是越接近的scale level表现出cost loss更低的现象。
总的来讲直觉上是符合的,但是否是在GPUs数量增加的过程中,“回撤”的那部分配置带来的额外收益,这个是有待考量的。
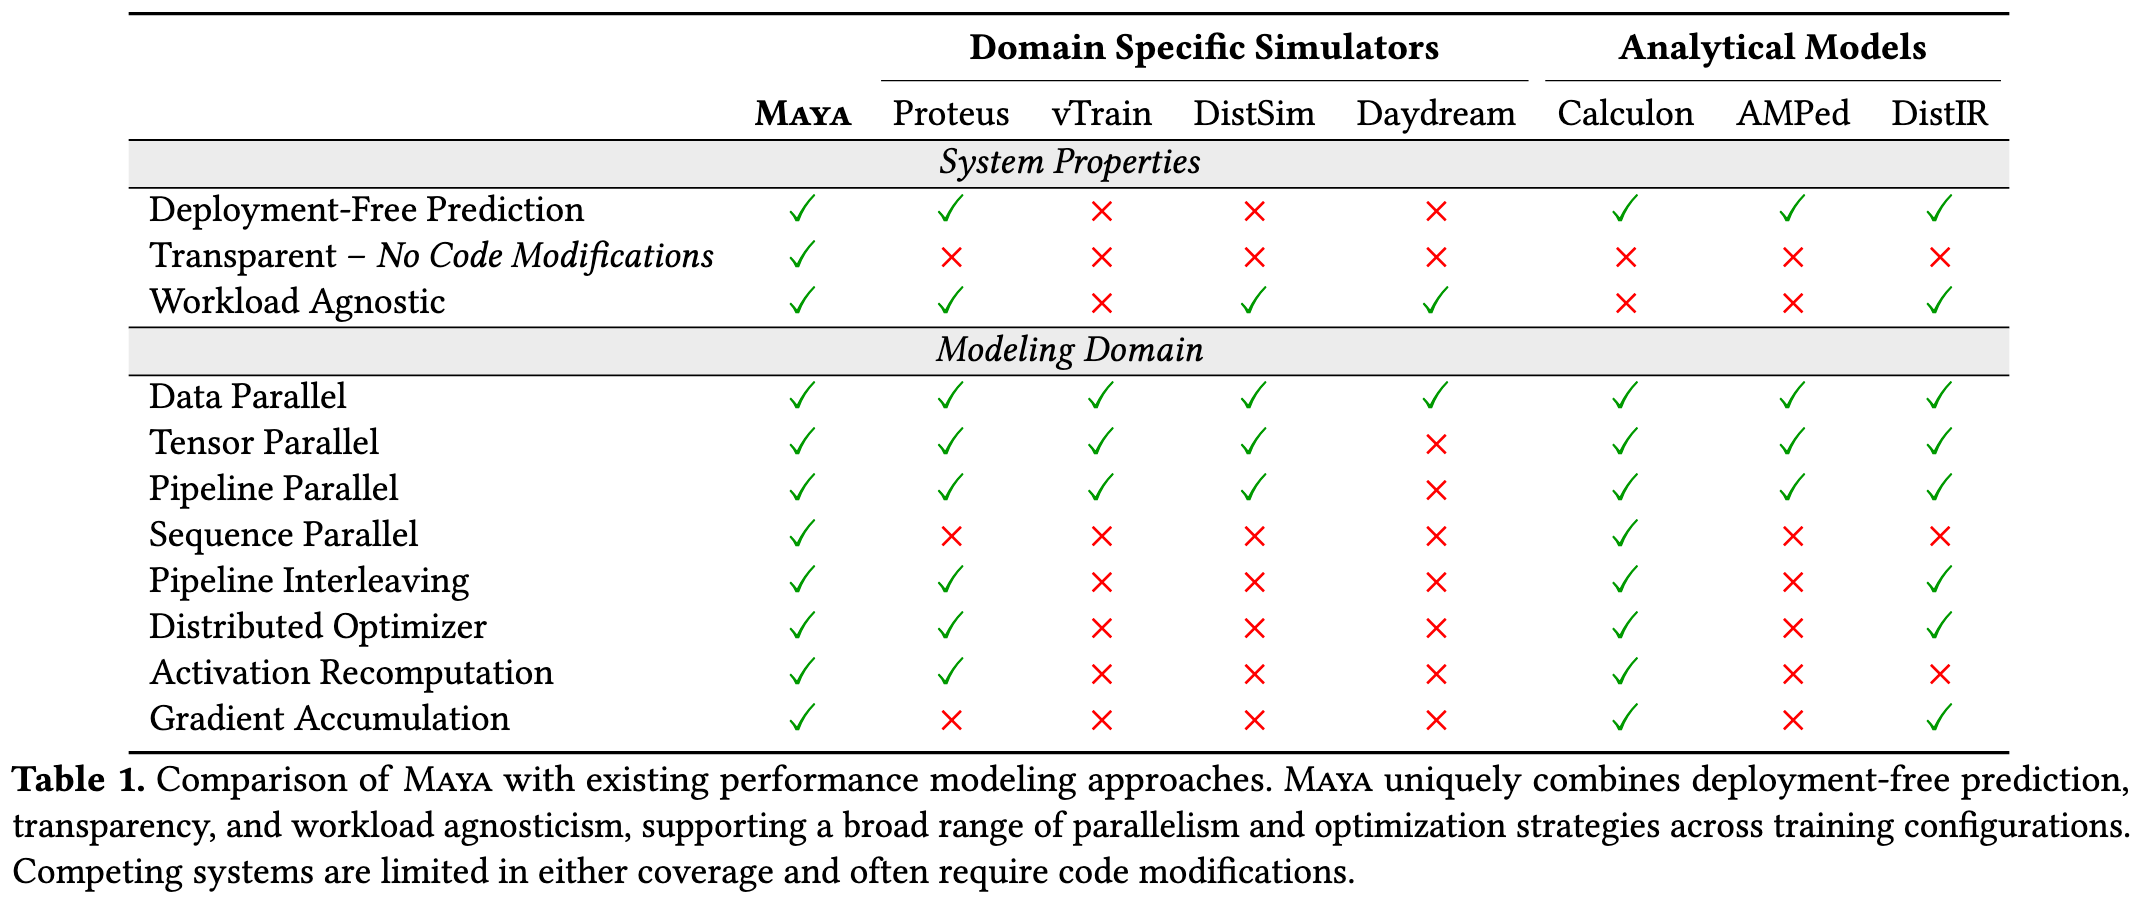
Domain Specific Simulators(领域专用模拟器):显式构建工作负载的 kernel 级执行图,然后逐事件模拟分布式执行——计算、通信、同步都作为图中的节点参与调度。需要把工作负载表达成自定义规范(Proteus 要写 strategy tree),或需要真实 GPU profiling
Analytical Models(解析模型):不写执行图,而是用闭式数学公式从高层配置参数直接算迭代时间。每一种新优化(sequence parallel、distributed optimizer、DualPipe 这类新调度)都必须有人手工推导并写进公式;公式天然是近似,保真度差。
System Properties 三行:考察系统本身的工程属性。
Modeling Domain 八行:考察对 8 种并行/优化技术的覆盖度。
没有什么信息量的表格,可以作为对其他方法的侧面刻画,但这里对MAYA的描述有点用力过猛。但从效果上看Calulon的泛化性似乎非常不错,这是SC23年的文章。GITHUB活得还不错。
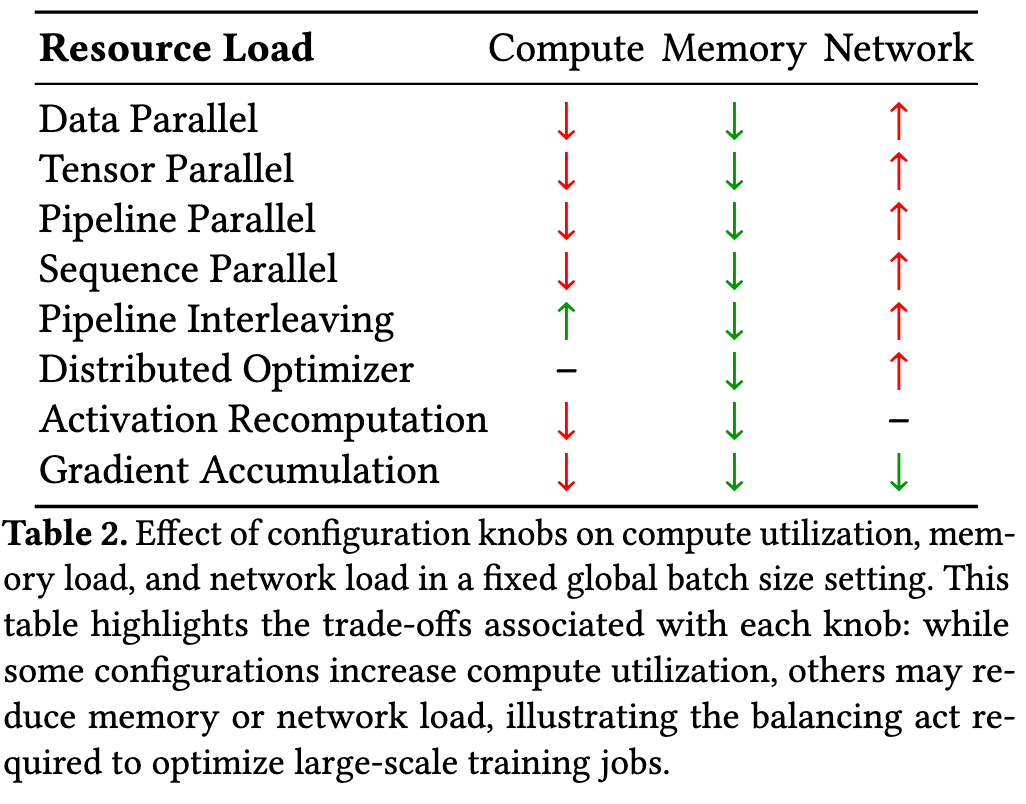
基本上大模型负载配置的trade off很明确,Low Memory Op.。但这个表格我觉得是有歧义的,trade off network不是真实的意图。scaling的过程中必须要增加网络负载(这当然必要),大部分优化都是希望减少network的overhead。增加这些DP、TP、PP、SP的维度并不一定会增加网络的负载。下面让我们细化一下这个情况
- 硬件不变(GPU 数固定)时:这个表大体准确
例如,固定 N 张卡、固定全局 batch,把某个并行度调大,每张卡分到的计算量必然 ↓。Network 列的 ↑ 其实是说通信/计算比(单位计算对应的通信压力)上升,而不是绝对字节数一定变多。
尤其对于这样一个并行方式,PP:。理想模型下,每个 microbatch 的激活张量只跨越 stage 边界一次,绝对通信字节数与 PP 度数基本无关;↑ 只能解释为”每卡计算量摊薄后通信的相对开销上升”。intra iteration time少了,通信压力就大了。。。
然而,这是最简单的情况,实际上,我们不可能无视硬件的去做parallel level的scale,绝大多数时候我们针对rack之类的情况去做组网和配置的计算。由此我们引入。
- 硬件可变(GPU 数随并行度扩展)时
- 弱扩展 DP(加卡同时加大并行度):通信计算比保持恒定,network的压力只取决于batch size。
- PP 加卡:p2p 通信量本来就小,加卡做 PP 对网络几乎无感,↑ 更不成立。
更别谈拓扑和层次化通信之类的常规配置更会直接反转这里的trade off,所以只能说这张表格太简单了。
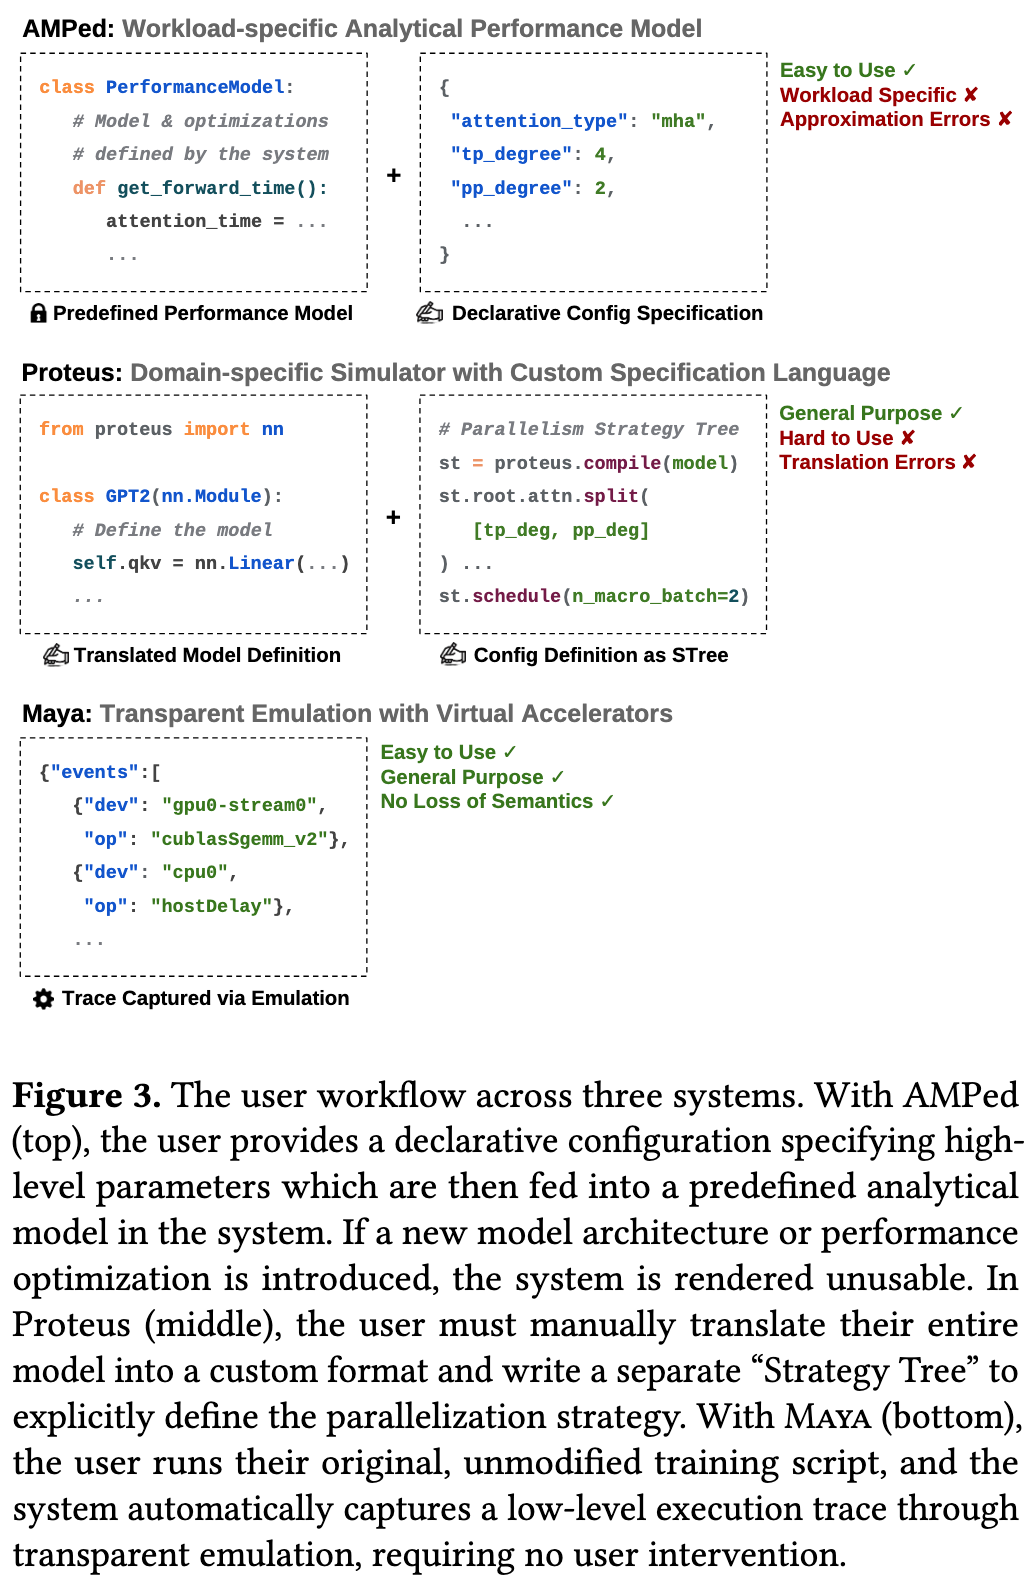
AMPed(上栏)——用户写 ~10 行,但被预置模型锁死。用户只填声明式配置(Fig 3 里的 attention_type: mha, tp_degree: 4, pp_degree: 2)喂给系统内置的 PerformanceModel.get_forward_time() 等解析公式。
Proteus(中栏)——用户写数百行。Proteus 的 Megatron-GPT 示例 实量 478 行——包括用 proteus.torchapi.nn 重写模型定义、构建 cluster topo、以及 Fig 3 所示的 strategy tree(st.root.attn.split([tp_deg, pp_deg])、st.schedule(n_macro_batch=2) 这类逐层声明)。
Maya(下栏)——用户写 0 行。直接跑原始训练脚本,trace 由仿真自动捕获。接入 Maya-Search 配置搜索也只需 <15 行改动(§6)。
对MAYA而言,其实现成本主要是CUDA 仿真器 ~2,500 行 C++(LD_PRELOAD 共享库);事件驱动模拟器 ~3,000 行 Python;搜索系统基于 Ray Tune 扩展。这些都是已经写好的东西。默认情况下其可插拔端到端模拟器采用随机森林实现(Vidur)。
Designs
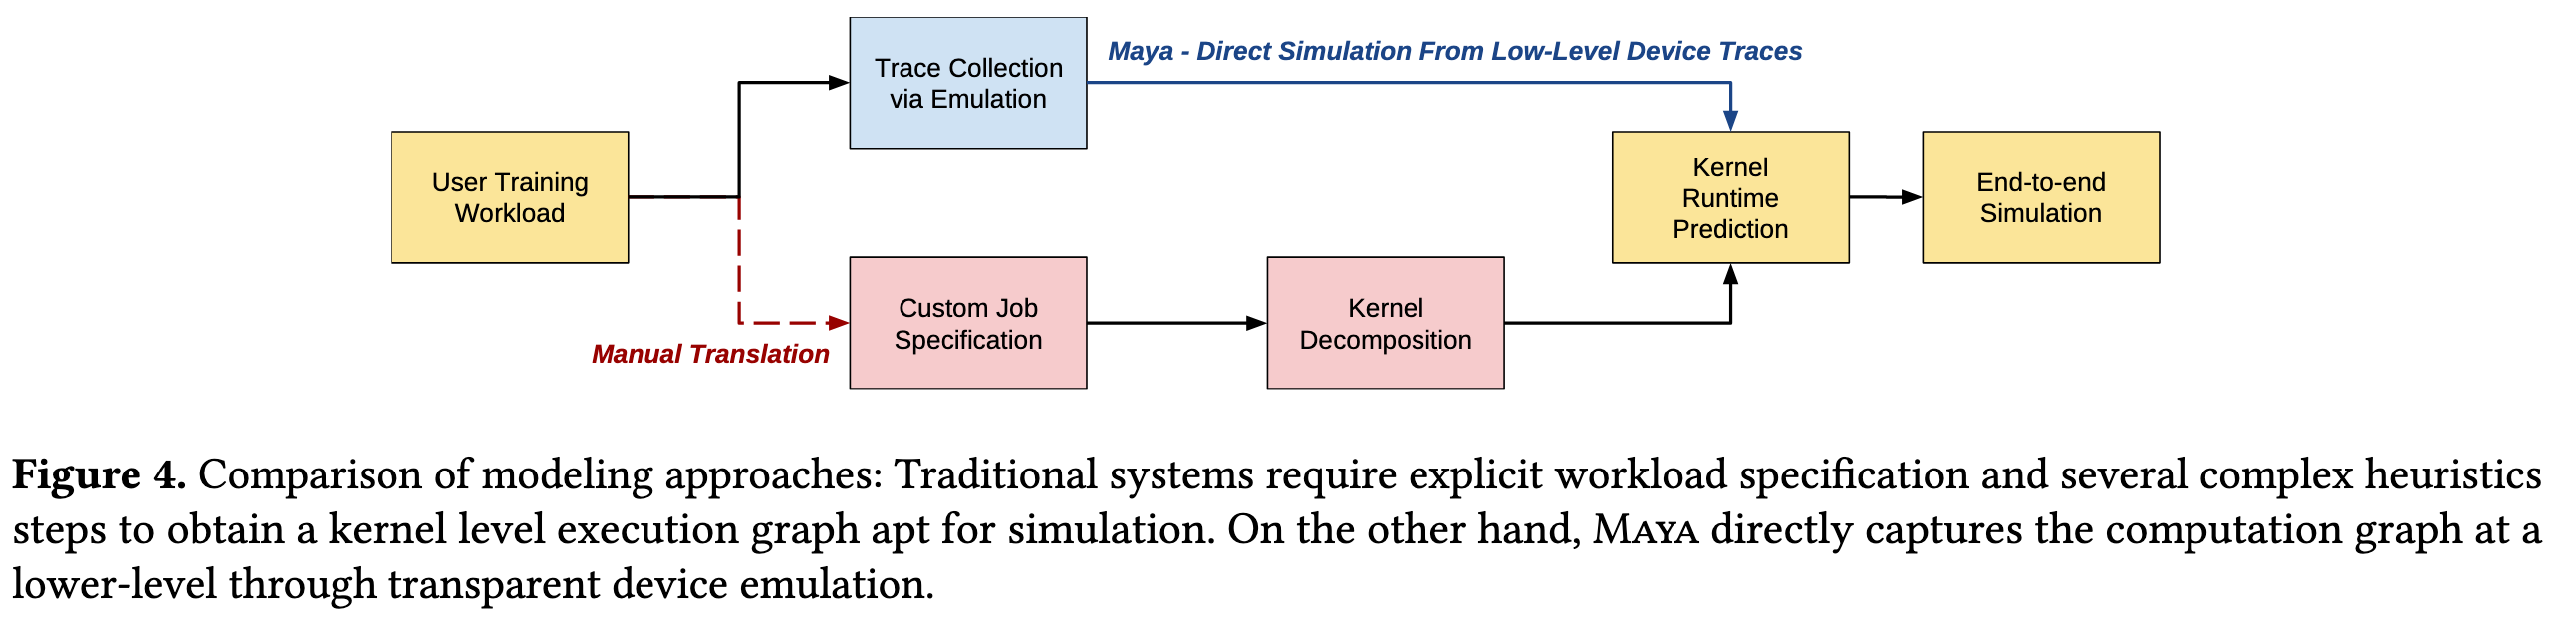
这是一个流程上的对比图,主要用于对比从User Training Workload到Kernel Runtime Prediction这个端到端流程的复杂程度。这里就是一个问题:Kernel执行图从哪来。这个图的下半部分是传统路线,上半部分是MAYA路线
传统路线需要两个额外阶段——Manual Translation(手写数百行规范,红色虚线标注)和 Kernel Decomposition(把规范启发式地拆成 kernel 执行图)。
Maya 用一个自动化阶段(Trace Collection via Emulation)把它们整体替换掉。在这整个过程中,table3所做的消融实验表明,把共享的 kernel 预测器换成真实测量值后,Maya 的误差降到 ~2%。Maya的这个自动化阶段的准确度相当高。
这里颜色的语义是红色 = 人工、易错、产生语义鸿沟的环节;蓝色 = 自动、透明。
值得注意的是Kernel Runtime Prediction并不是Maya的主要创新范围,实际上,这个模块的问题还是很大,一句话是:如何快速准确的预测各种Kernel的执行时间。这是一个非常困难的问题,一般而言,现有的系统只能在预测时间开销与预测准确性上做取舍。
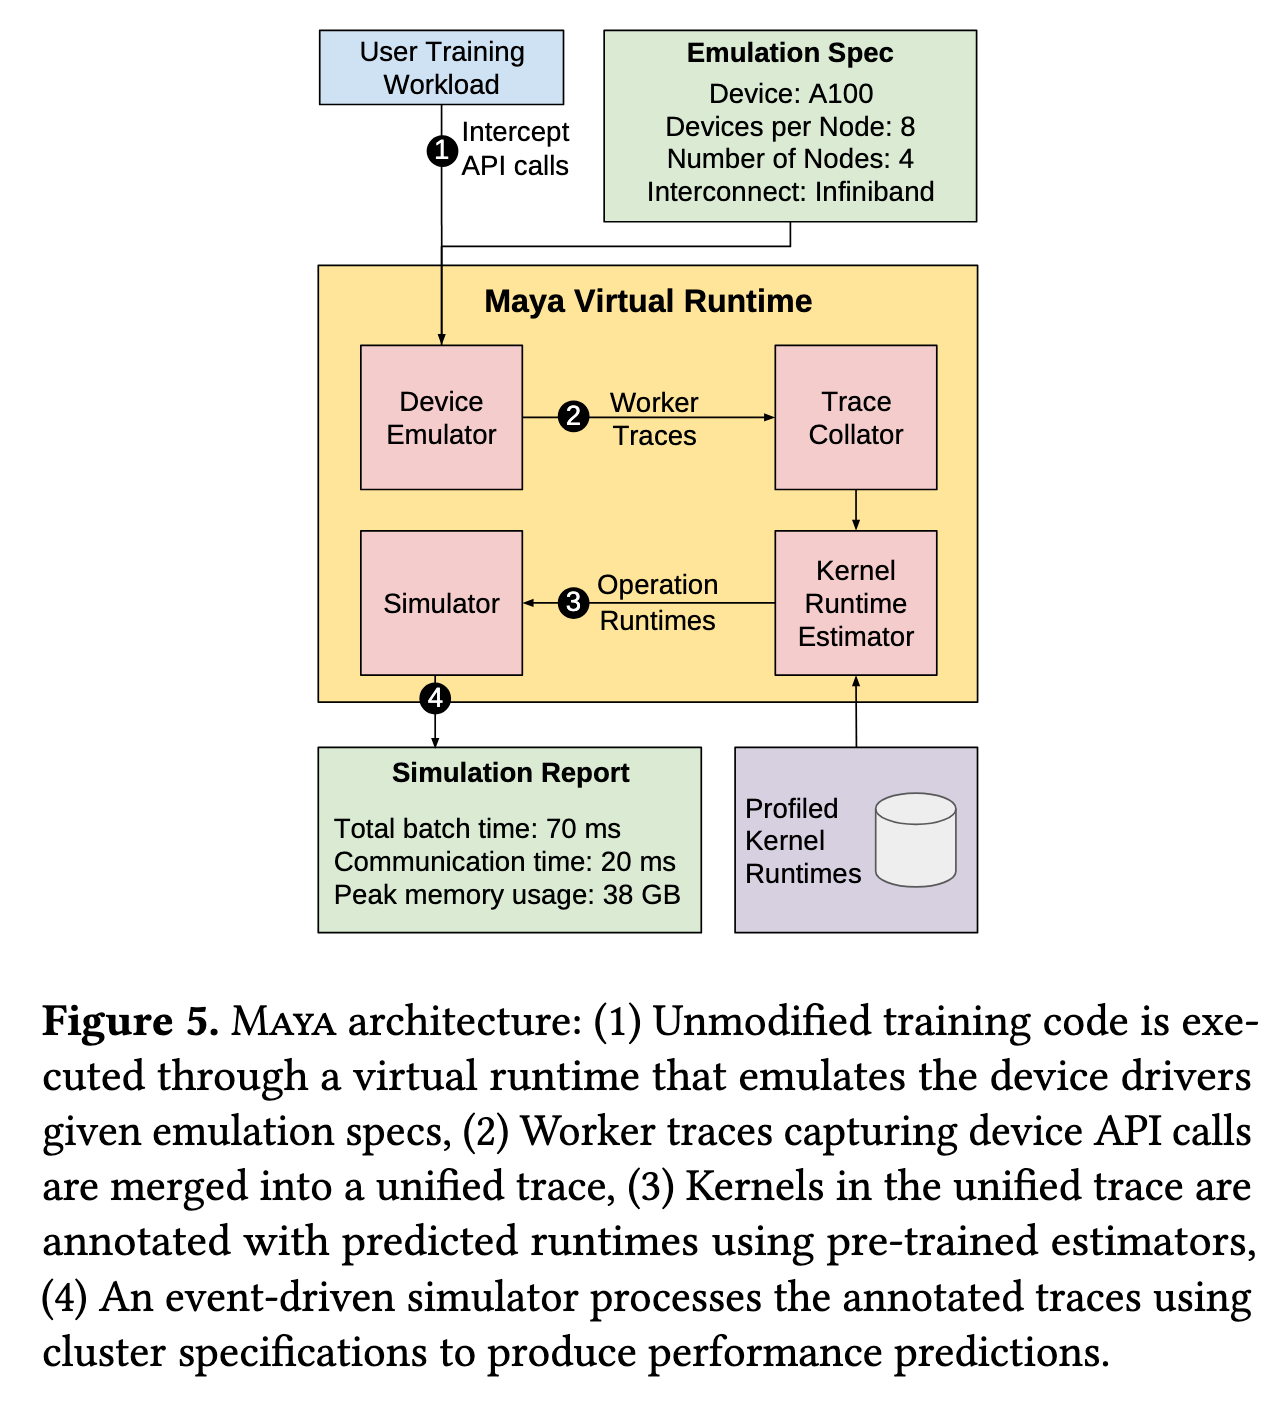
这张架构图除去IO外,主要是将fig3中的蓝色部分展开成了四个红色的组件,这四个组件(emulation / collation / estimation / simulation)都可独立替换调优。
① Device Emulator(设备仿真器,§4.1)
拦截CUDA API并维护硬件信息,用CPU模拟GPU
② Trace Collator(轨迹合并器,§4.2)
对每个emulator worker产生worker trace,collator把多条worker trace按communicator ID和序号匹配集合通信、合并成全局统一轨迹,重建分布式执行模式。一个关键优化是对于多个行为相同rank只profile一个
③ Kernel Runtime Estimator
数据来源是旁边的紫色圆柱 Profiled Kernel Runtimes——预训练的估计器(默认随机森林,基于微基准 profiling 数据)
④ Simulator(事件驱动模拟器,§4.3)
拿着标注好时长的 trace,按 cluster spec 做离散事件模拟:建模 stream 并发、同步阻塞、计算-通信重叠、流水线气泡,最终输出 Simulation Report。
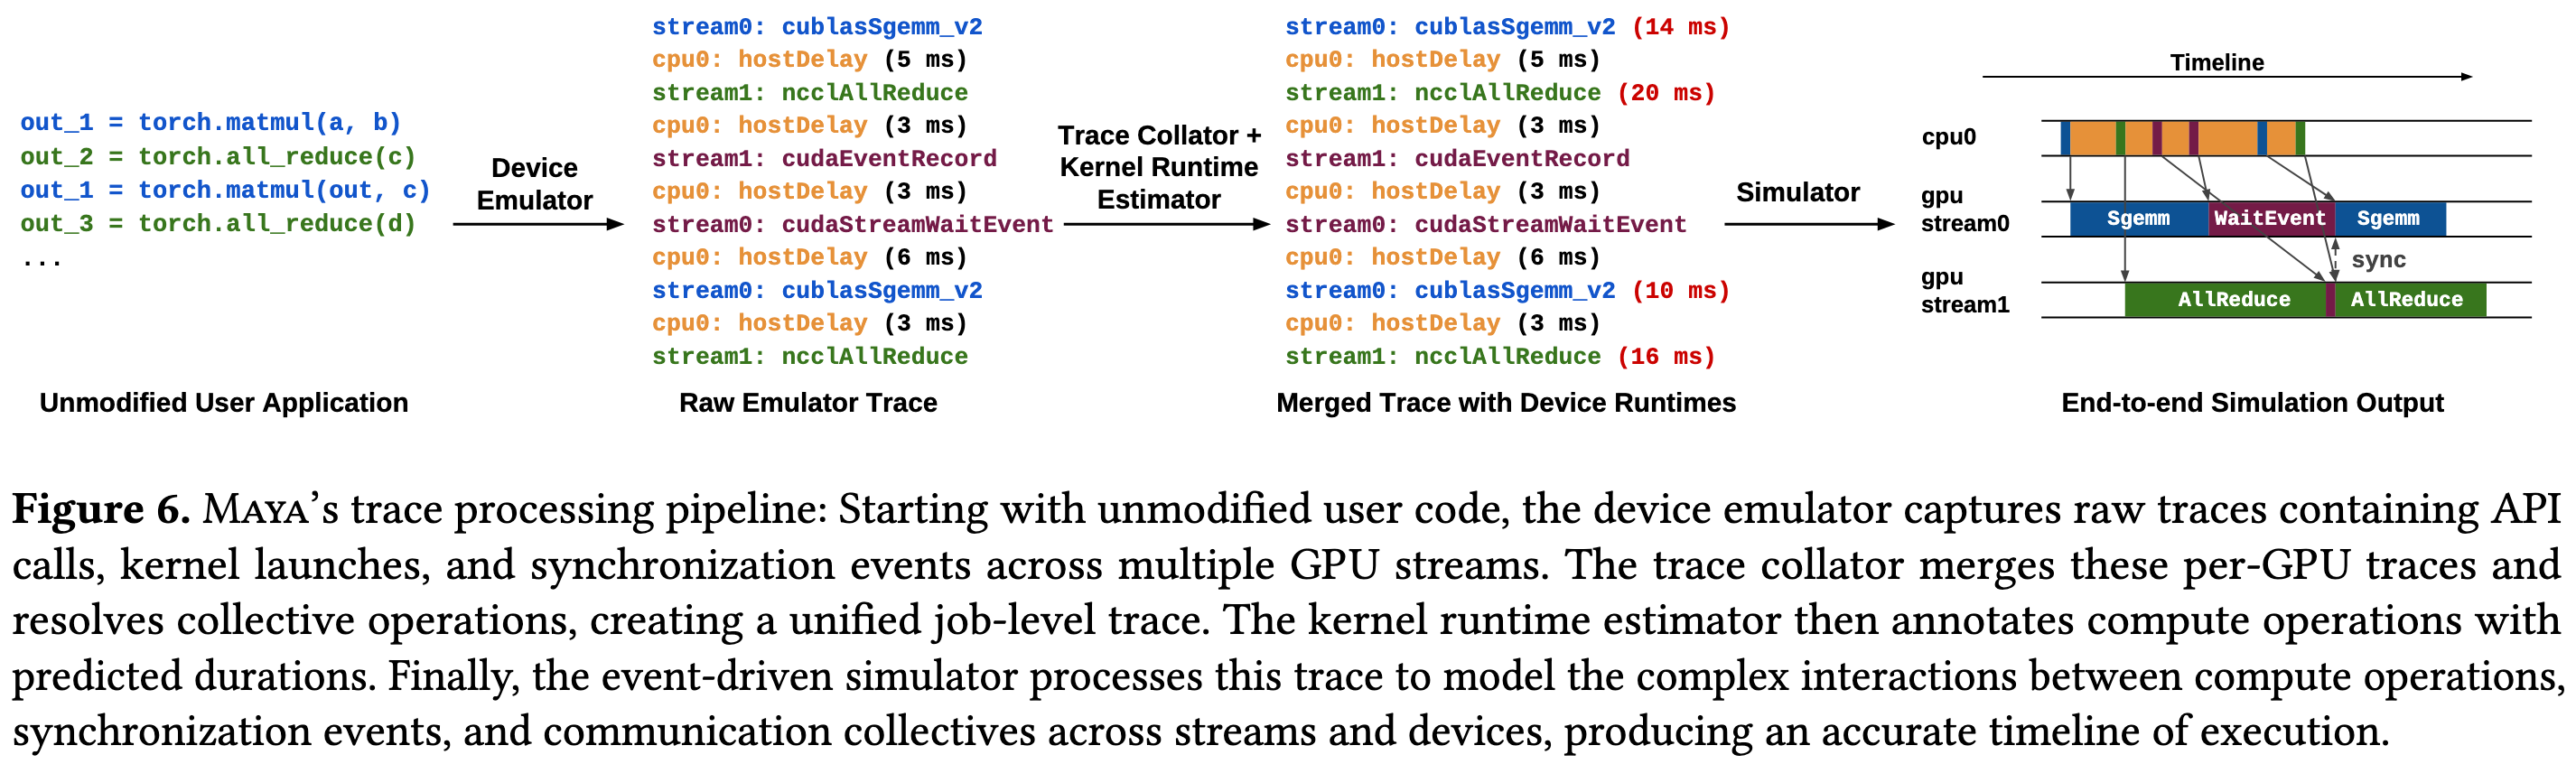
一段未修改的 PyTorch 代码 → 原始仿真 trace → 合并并标注时长的 trace → 模拟出的执行时间线。
在这个例子中主要证明的是,以下三类开销都会被准确记录:
- 计算-通信重叠
- 跨 stream 依赖造成的停顿
- host 端调度开销
具体阐述如下:
- 用户代码作为输入
# 用户代码:带通信的FFN
out_1 = torch.matmul(a, b)      # 计算 → stream0
out_2 = torch.all_reduce(c)     # 集合通信 → stream1(独立通信流)
out_1 = torch.matmul(out, c)    # 计算,依赖第一次 all_reduce 的结果
out_3 = torch.all_reduce(d) # 通信- Raw Emulator Trace(Device Emulator 产出):补充调用之间的hostDelay(emulator 拦截每个设备 API 调用时记录 wall-clock 时间戳,相邻两次调用的时间差就是一条
hostDelay记录)。并且增加关键同步原语:stream1: cudaEventRecord+stream0: cudaStreamWaitEvent。
对于这里的hostDelay,之所以可以这样通过wall-clock的时间戳认定,是因为在emulation期间,所有的GPU设备操作都被变成no-op。显存分配只是虚拟的,集合通信也不传真实数据。
上一次 API 调用返回的时刻 → 下一次 API 调用进入的时刻 = hostDelay
- 测量环境保护:正因为 hostDelay 是裸 wall-clock,外部干扰(其他进程抢 CPU)会变成噪声。所以 Maya-Search 跑并发 trial 时强制绑核 + 每个 emulated worker 跑完再切换(§5.1),保证测到的 hostDelay 真的是负载自身的开销。
对于同步原语而言,Maya采用的方法是通过LD_PRELOAD共享库替换
cudaEventRecord、cudaStreamWaitEvent、cudaDeviceSynchronize等符号,维护设备状态映射。
cudaEventRecord(event, stream):在状态表中登记”该 event 关联于 stream1 当前已排队的操作序列尾部”;cudaStreamWaitEvent(stream, event):查表解析出”stream0 从此刻起依赖于 stream1 上那个 event 之前的所有操作”;- 两者连同其余 API 调用一起写入 worker trace。
- Merged Trace with Device Runtimes(Collator + Estimator 产出):合并多 worker trace、解析集合通信,并由 kernel 估计器给每个算子标注时长:
Sgemm (14 ms)、AllReduce (20 ms)、第二个Sgemm (10 ms)、第二个AllReduce (16 ms)。hostDelay 原样保留。
在这里对于计算kernel而言,Maya采取的计算方式是ML回归器预测。
- 默认方案:随机森林回归器(random forest regressors),在真实GPU上的kernel微基准(microbenchmark)profiling数据上训练——即事先在目标型号GPU(V100/H100等)上把各类 kernel按不同 shape/dtype 组合跑一遍、记录实测时长,然后用(算子类型,输入形状,dtype,layout)→ 时长训练模型。这个做法沿袭自Vidur和Daydream。
- 可插拔:用户可以替换成任何估计器——Habitat 14(跨设备外推)、GPU-Mangrove 5、静态分析 2 等,按 kernel 类型单独指定。
- 冷启动/新算子:Maya 提供”透明 profiling 模式”(transparent profiling mode)——遇到没见过的算子时,把它真实 dispatch 到硬件上执行一次,记录参数和实测时长,逐步扩充训练集。
对于通信算子而言,Maya采取的方式是链路profiling数据+黑盒预测
- 估计器的输入是:集合通信类型、数据量、参与设备的拓扑(rank 数、机内/机间链路分布),参照数据是机内(NVLink)和机间(Infiniband/RoCE)链路的 profiling 数据——典型来源是 nccl-tests 在目标集群上的实测。
- 模拟器侧的协作(§4.3 Network Model):集合通信在建模时被拆成两段——
- 到达/同步段:用全局waitmap建模,各参与rank注册后阻塞各自stream,直到全员到齐。这段产生的是排队和气泡效应,由模拟器从数据依赖里自然推出,不需要预测;
- 在网传输段(on-the-wire duration):全员到齐后,整个集合通信的传输时间作为一个黑盒离散事件由估计器一次性给出,拓扑相关的效应全部抽象进这一个数。
- 可替换为网络模拟器:没有目标集群实测数据时,可以把这段换成ASTRA-sim做网络级模拟。
在后续的oracle消融实验中,这两个预测时间的误差是Maya误差的主要来源,另一个值得注意的点是,通信 kernel 与计算 kernel 在 SM 上的资源争抢(SM contention)完全没有建模。
-
End-to-end Simulation Output(时间线):三条泳道:
- cpu0:一串小色块,串行 dispatch,体现 launch 开销;
- gpu stream0:
Sgemm(14ms)→WaitEvent(红色,停顿)→Sgemm(10ms); - gpu stream1:
AllReduce(20ms)→AllReduce(16ms),末尾sync。
这里主要体现流水线依赖与建模过程中气泡的存在。
这里论文中并没有提到这一条可视化工件,最终的交付物是Simulation Report:Total batch time / Communication time / Peak memory useage 三个聚合指标。
但确实有维护等价这条时间线状态的数据。离散事件模拟器(§4.3,~3000 行 Python,优先队列驱动)给每个事件分配起止时间、挂到对应资源(host dispatch queue、GPU stream)上,
WaitEvent造成的停顿、AllReduce与Sgemm的重叠,都是模拟过程中真实计算出来的调度结果
Experiments

回顾一下这里对对比方法
| 基线 | 类别 | 方法回顾(对应 Table 1) |
|---|---|---|
| Proteus | 领域专用模拟器 | 手写 strategy tree + 层级拓扑感知执行器,还在真 GPU 上 profile kernel |
| Calculon | 解析模型 | Megatron 系 LLM 专用,配置参数 → 闭式公式,我们前面提到的适配性很好的模型 |
| AMPed | 解析模型 | 同样是 transformer 训练专用解析模型 |
这里文章中说选用GPT3作为workload,是因为这是AMPed与Calculon唯一原生支持的负载。更细的模型配置上Megatron-LM GPT-3系列 2.7B / 18.4B / 145.6B,对于每一个参数大小全局batch分别 256 / 512 / 12k,bf16 混合精度,HuggingFace Accelerate + PyTorch 2.1.0。而在硬件上,这里对比了不同规模与代际的芯片,跨度有些大分别是V100与H100。
- V100 DGX:8/16 卡,40GB HBM,机内 NVLink 非对称 cubemesh 300GB/s,机间 100Gbps InfiniBand;
- H100 DGX:32/64 卡,80GB HBM,机内 NVLink4 900GB/s,机间 RoCE 400Gbps/卡。
这 100 个配置是从每种硬件场景下 ~2000 个配置点的空间里,取实测性能 top-100 得来的(Fig 7 caption: “top 100 valid configurations ranked by measured performance”;“valid” 指能正常跑完、不 OOM 的配置)。这个空间由 8 个配置 knob 组合而成(§7.1),具体变量和取值范围在 Table 5 里:

另一个值得注意的点是:可以注意不同方法在有些配置下无法进行仿真,其中Maya的泛化性是最强的。
这里对着四种不同方法的估计偏差做一下初略的解释。
-
紫色的线在哪里?
AMPed很遗憾的系统性高估了2-3x的时间。原因基本可以归结于预置算子模型偏保守(留了较大裕量)。
-
为什么Proteus与Calculon都系统性低估了Iteration Time?
他们没有建模的内容,包括kernel launch/dispatch 开销(Fig 6 里的 hostDelay)、同步等待、显存分配器行为、优化器step、gradient clipping等使得他们漏算了开销。
其次,解析模型通常假设计算-通信完美 overlap、流水线无气泡。而 Fig 6 那个 case 已经展示了现实:跨 stream 依赖会把通信暴露在关键路径上(WaitEvent 空等 ~6ms)。这些涌现性停顿在静态公式里不存在。
最后,对带宽的估计也过于理想了,导致其乐观估计了通信开销。
这里的主要归因可以用Maya论文3.2节的一句话总结”garbage in, garbage out”。

fig8的数据实际与fig7的数据是一致的,对各个方法在不同场景下的预测值去argmin并放回真实集群实测。
- 绝对误差 ≠ 选错配置。Proteus 在 V100 上保真度不错,但 +5%/+6% 说明排序在头部出了错;Maya ≤+2% 说明它的排序在 top 区域几乎无损。
- 系统性偏差的方向很要命。Calculon 系统性低估 → 会把实际不快的配置误判成快(64×H100 上 +10%);AMPed 高估 2–3× 且误差分布不均 → 64×H100 上选出贵 56% 的配置。偏差单调时排序尚可能幸存,误差一旦因配置而异(heteroscedastic),argmin 就必然踩坑。

依旧是不同视角下的误差分布展示。分别对GPT3 2.7B @ 8×V100 和 GPT3 18.4B @ 64×H100(最小和最大两个规模)场景进行展示。这里主要是补充对误差的统计分布,可视化尾部风险。这里主要说明Maya的误差不睡配置而剧烈变化,针对任意单一配置的模拟并没有显著误差,并且再不同规模的硬件结构中没有显著的漂移。
这里有一个脚注是:作者就 Proteus 和 AMPeD 的异常结果联系过原作者但未能解决。

Oracle与E2E的区别主要在于:是否使用回归器预测不同kernel的运行时间。
E2E 是 Maya 的真实水平,Oracle 是”假如 kernel 预测完美,Maya 这套框架能达到的上限”。E2E − Oracle 的差值就是回归器贡献的误差。
Maya 的误差有两个来源:
- kernel 耗时预测器(随机森林回归器)的误差**;**
- emulation + simulation 阶段的细节损失(trace 是否完整、依赖建模是否精确、host 开销测量等)。
这里基本上只是证明,Maya在消融回归器的误差后,Maya这个框架的上限可以达到0.14-4.10%的误差。这里直接支撑了 §4.3 把估计器做成可插拔的设计决策。
- 几行 E2E < Oracle 的反常(如 2.7B TP1 的 0.30 < 0.70,TP4 的 3.20 < 4.10、4.00 < 6.00):caption 自己解释了——“barring a few cases attributable to noise”。回归器的误差是随机的,偶尔会反向抵消框架的系统性偏差(负负得正),加上实测本身有噪声,个别行 E2E 反而更低。
- 覆盖面的信号:三档模型规模(1.3B/2.7B/7B)、单机8卡到跨机32卡、TP/PP/GA各种组合下结论一致——误差结构不随并行策略变化而失稳。


这里是对Megatron意外框架的补充,这里还支持PyTorch生态(torch.compile、FSDP、DDP)和DeepSpeed(ZeRO 1-3、activation offloading)的训练脚本。从模型的维度,他还支持横跨9个架构,从CNN(ResNet/DenseNet/MobileNet/VGG)和各种transformer(BERT/GPT/Llama/T5/ViT)证明不只是对GPT3的层结构有效。
fig10中额外补充了在ResNet、A40配置下的iteration time的预测。证明即使在非LLM,非Megatorn,非DGX规整拓扑,带torch.compile下也能有不错的预测配置。此外,该图的配置也对应着table9的配置。另外,table 7&8的配置对应着figure7,也就是用magetron跑GPT3的那个配置。
值得注意的是,这里不是随便列举的。例如对于torch.compile而言,会产生编译器生成非常规的kernel(考验kernel估计器的覆盖);ZeRO/offload 涉及统一内存和 host-device 传输(考验 §4.1 的资源追踪);脚本自带的输出校验步骤会读 buffer 内容导致仿真失败(用小 buffer memcpy 糊弄过去)。
附录中kernel预测精准度,即各个不同kernel的mean absolute percentage error

Table 9(A40 + ResNet152 + torch.compile 那组实验,即 Fig 10 对应的设置):triton kernel 的 MAPE 只有 4.13%,重要的卷积 kernel(cudnnConvolution 系列)6%–9%。

为什么有些 kernel 误差 100%+ 也没关系?Table 9 里 nll_loss_backward MAPE 253%、softmax_warp 229%,但 caption 说这些 kernel 时长极短,对端到端延迟影响可忽略。
综合分析的看,Maya要能够成立主要是对于§3.4 的两个前提而言的:
- 窄腰假设:所有框架最终都收敛到同一套设备 API(CUDA/cuBLAS/cuDNN/NCCL)——拦截这一层就够;
- 解耦假设:CPU 控制流不依赖 GPU 计算结果——所以 kernel 可以不真算,只记元数据。
对于这里的例子,我们来分别仔细看一下这里的例子选取。
DeepSpeed 的 ZeRO 1-3 + Activation Offload:这里重计算与offload的只能是垃圾数据,这里需要框架做到无论传输内容,都能保证预测稳定.
torch.compile:编译器会现场生成融合 kernel(Triton codegen),这些 kernel 不在任何预置算子集里。解析模型路线(AMPed 那种预定义 get_forward_time() 公式)遇到编译器生成的新 kernel 就得人工补模型;Maya 拦截的是 CUDA API 层,kernel 是谁生成的它根本不关心——这是对”窄腰假设”的检验(附录 B 有细节)。
Maya 默认的 kernel 预测器是按 kernel 类型分别训练的随机森林回归器——
cublasSgemm_v2、cudnnConvolutionForward这类库 kernel 种类有限、签名稳定,每种攒一批”shape/dtype → 实测时长”的数据就能训练。torch.compile 打破了这个前提:它通过 Triton 现场生成融合 kernel,算子组合方式极多,生成的 kernel 签名(signature)数量爆炸。如果还按”每种 kernel 一个回归器”的老办法,每种融合模式都只见过零星几次,根本没有训练数据——这就是正文把 torch.compile 列为 Table 4 压力测试项的原因。
解法:从”看输入”变成”看 kernel 内容本身”
论文的原话(附录 B):
We address this by collecting information from the compiler IR about the content of the kernels rather than just their inputs.
具体做法:对 Triton 生成的 kernel,不再只用输入张量的 shape/dtype 当特征,而是从编译器 IR 中提取 kernel 本体特征——实验证明有效的特征是 kernel 定义中基础 Triton 指令的数量统计(add、sub 等原语各有多少条)。这相当于用”这个 kernel 内部做了多少算术工作”来预测耗时,而不是靠”它叫什么名字”。
训练数据的收集方式也相应改变:扫不同模型/ batch size 的工作负载 trace,从中抽取这些 IR 特征并配上实测时长(即 §4.3 的透明 profiling 模式)。
FSDP / DDP:PyTorch 原生分布式策略的通信模式和 Megatron 完全不同:FSDP 用 all-gather/reduce-scatter 加 bucketing,并与计算做细粒度重叠。这检验的是 Trace Collator 对集合通信的解析能力是否只适配了 Megatron 的 NCCL 使用习惯。
9 个模型(ResNet/DenseNet/MobileNet/VGG/BERT/GPT/Llama/T5/ViT)—— 考验架构无关性 CNN 和 transformer 的 kernel 构成完全不同(卷积 vs attention/matmul),encoder-only/decoder-only/encoder-decoder 的迭代结构也不同。覆盖它们是为了说明 Maya 没有隐含假设”负载长得像 GPT”。
ResNet152 @ 8×A40(Fig 10 的定量抽查)—— 挑一个离主线最远的点 正文明说选它是因为 “particularly challenging”:A40 节点的 GPU 间是异构链路(pairwise NVLink 4.0,拓扑不规则),又是视觉模型,又开了 torch.compile——三个不利因素叠加,离主实验(Megatron-GPT3 @ V100/H100 规整 DGX 拓扑)距离最远。在最差的条件下仍有半数配置误差 <5%,这是”角落案例也能用”的证据。
在§7.2 “Framework Generality”小节中,作者表明:仿真时所有 GPU kernel 都是 no-op,设备 buffer 里从来没有真实计算结果——matmul 的输出 buffer 里是未初始化的垃圾值。但”野外”抓来的训练脚本(DeepSpeedExamples、HF Accelerate 的示例)有时会带主动校验逻辑,例如:
- 分布式初始化后,每个 rank 往 buffer 写入自己的 rank id,all_gather 之后检查
buffer[i] == i(验证通信组建立正确); - 检查 gather 回来的张量个数/顺序是否符合预期;
- 跑一个 step 后读回 loss 值做 sanity check。
这些校验需要把buffer内容拷回host(cudaMemcpy DtoH)再读值。仿真环境下读回来的全是垃圾数据 → 断言失败 → 脚本直接挂掉。
作者给出的缓解方案是:
允许仿真器对小 buffer 真的执行 memcpy(mock host-host 和 host-device 传输)。为什么这能奏效:这类校验检查的是元数据性质的内容——张量个数、rank 顺序、shape 标记——而这些小数据往往是 host 端生成的(比如 rank id 数组本来就是 CPU 上算好再 HtoD 拷进去的)。只要仿真器不偷懒、把小的 HtoD/DtoH/DtoD 拷贝真做掉,这类内容在仿真里就是真实正确的,校验自然通过。大 buffer 不真拷(没意义也没必要),小 buffer 真拷的成本可忽略。
但如果再扩展一步:如果控制流真的依赖计算结果——典型是某些 MoE 实现在 host 端读 gate 输出来决定把 token 发给哪些 expert——那仿真的控制流本身就走错了,不是糊弄校验能解决的。作者给的出路是对 gating 函数打标注,仿真时不返回随机张量而是从分布里采样,产出”一族”可能的运行时(也指出主流的 expert-parallel 实现如 DeepEP/pplx-kernels 已经把 gating 移出 host,所以受影响面很小)。


Table 5(7 knobs → 1920 配置点)
        │  穷举 = 1920 × 每点评估成本 → >24h(Table 6)
        ▼  CMA-ES + 去重/剪枝/并发/早停
Fig 11a:搜索 <1 小时完成
Fig 11b:找到的配置与穷举几乎一样好(≤+5%),且都贴近实测最优
4 × 4 × 5 × 3 × 2 × 2 × 2 = 1920 ≈ ~2000 个配置点——正好对上 §7.1 说的 “∼2000 points for each hardware cluster”(DP 不在表里,因为它是 GPU 总数÷TP÷PP 的派生量)。
(a) 搜索耗时:CMA-ES + 全部优化(worker 去重、并发 trial、保真剪枝、早停)下,四个场景的完整搜索分别在 ~21 / ~19 / ~38 / ~42 分钟完成,全部在一小时内。
(b) 找到的配置质量:柱子是”搜索找到的配置的归一化成本”(相对实测最优,红色虚线 = 1.00),两组对比:
- Maya(CMA-ES 搜索):8×V100 和 32×H100 上恰好命中最优(1.00),16×V100 和 64×H100 上略差(~1.05);
- Maya-Grid(用Maya评估器做穷举,作为参照):全程 ~1.00–1.02。
CMA-ES 偶尔比穷举差 3–5 个点,是启发式搜索正常的质量-速度权衡;关键是两者都远优于 Fig 8 里基线系统的 +5% ~ +56%。
CMA-ES(Covariance Matrix Adaptation Evolution Strategy,协方差矩阵自适应进化策略)无梯度黑盒优化算法
它把搜索空间当作一个未知地形的黑盒,维护一个多元高斯分布作为”采样器”,迭代地做三件事:
- 采样:从当前高斯分布中抽一批候选点(一批配置);
- 评估:用目标函数(这里是 Maya 预测的迭代时间/MFU)给每个候选打分;
- 更新分布:把分布的均值往表现好的候选方向移动,同时自适应调整协方差矩阵——让分布”学会”搜索空间中变量间的相关性和各方向上的合适步长。
“协方差矩阵自适应”就是它的精髓:如果搜索发现沿某个方向(比如增大 TP 度数)持续变好,分布会在这个方向拉长;如果两个变量存在交互(TP 和 microbatch 数耦合),协方差会学到这种斜向结构。它不需要梯度、不需要目标函数可导、甚至不需要目标函数有解析形式——只要”给一个点,能算出分”。
Grid在这里是grid search的含义。即使用Maya做评估器,对Table5定义的离散网格做穷举搜索。

这里期望假设的场景是Maya能否研究其根本接触不到的超大规模的集群。这里连集合通信的 profiling 数据都没有,网络部分接了 ASTRA-sim。
在第一张图中,并行配置完全固定(TP8、PP8、全局 batch 12K、64 microbatch),只调 DP 度数,把集群从 1K 扩到 12K GPU,迭代时间从 44.40s(1K)→ 22.38s → 15.93s → 12.44s → 8.97s → 5.74s(12K);MFU 曲线从 ~45% 一路跌到 ~32%。这里GPU提升12x,迭代时间只降到了原来的1/7.7,MFU从接近50%,减到了35%以下。Maya在没有大规模集群的情况下复现出了这个定性行为。
第二张图中说明了随集群规模的扩大,Maya本身的可扩展性。这里表明,在模拟集群扩大的过程中,主要增加的时间成本处在Emulator组件上。这得益于worker的去重,无论多少张卡,唯一rank只有8个(每个PP stage各一个)。emulation的工作量与GPU总数脱钩。但集合通信中的waitmap的参与者变多,事件总数增加。

这两张”简单”的图其实是 Fig 11 的归因分析:Fig14是说这里的去重优化带来的贡献,很好理解的,它还减少了仿真过程中的内存占用,使并发 trial 数得以提高。
堆叠柱:Executed(橙,真正跑仿真评估的)、Cached(蓝,结果可复用的)、Skipped(绿,被保真剪枝跳过的);

基本上这里是对各个阶段优化的一个系统性展示,其中total serch time的爆炸增长来源于grid的搜索策略。
Appendix
这里主要使用了三个伪代码展示了模拟器(Emulator)中的核心算法


- Algorithm 1(离散事件主循环):优先队列驱动——trace 里的 host op 和 host 开销先入队为
HostOpArrivalEvent,主循环不断取最早事件、推进时钟、多态分发处理、把新产生的事件回插队列。 - Algorithm 2(调度器):资源模型——每个 device/stream 有 busy 标志和等待队列;资源被占就排队(阻塞),
op_complete释放资源并唤醒下一个 op。 - Algorithm 3(两张全局 wait map):
CudaEventWaitMap:(event_id, version) → 等待的 op 列表。注意 version 字段——CUDA event 句柄会被复用,不加版本号就会错配,这是只有真做过 CUDA 模拟才会踩到的细节;NetworkCollectiveWaitMap:(nccl_group_id, call_idx) → 参与者 kernel 列表。所有 rank 到齐后集合通信才放行,EndEvent 设在”预测时长”之后——即 集合通信被建模为全局同步点 + 黑盒时长,作者坦白这对 NCCL 的 setup/teardown 不完全忠实,但对端到端延迟足够准。- 收尾一句点题:任意流水线调度(含 DualPipe)都只是这些同步原语的组合——所以 Maya 不需要为新调度写任何显式模型。这是 Fig 3 论证在算法层的兑现。
Fig 6 trace 条目 模拟器中的处理 cpu0: hostDelay (5 ms)host dispatch 队列上的阻塞操作(实测 wall-clock,直接占用 cpu0 资源) stream0: cublasSgemm_v2 (14 ms)schedule_operation:stream0 空闲 → 占用,登记EndEvent(t+14ms)stream1: ncclAllReduce (20 ms)NetworkCollectiveWaitMap.JoinCollective:到齐才放行,EndEvent(t+20ms)stream1: cudaEventRecord触发 CudaEventWaitMap.ReleaseWaiters(event_id, version)stream0: cudaStreamWaitEventCudaEventWaitMap.BlockOnEvent(event_id, version):stream0 停住t=0 起,cpu0 串行 dispatch(Algorithm 1 主循环 + Algorithm 2 资源检查):
- launch Sgemm① 到 stream0:Algorithm 2 检查 stream0 空闲 → 标记 busy,
EndEvent(14ms)入队。此刻 stream0 开始干活。- hostDelay 5ms:cpu0 被阻塞 5ms——注意这期间 stream0 的 Sgemm① 在并行跑,host 开销与设备执行天然重叠。
- launch AllReduce① 到 stream1:进入
NetworkCollectiveWaitMap.JoinCollective——该 kernel 注册到(group_id, call_idx)名下;等所有 rank 到齐才统一放行(全局同步点),放行后EndEvent(+20ms)。这里隐含了第一层真实行为:慢 rank 会拖住整个集合通信(到齐时间由最晚参与者决定)。- hostDelay 3ms → cudaEventRecord 落在 stream1:它是 stream1 队列里的一个”op”,排在 AllReduce① 之后,AllReduce① 完成时才真正 record。
- hostDelay 3ms → cudaStreamWaitEvent 落在 stream0:
BlockOnEvent—— stream0 从此停摆,后续 op 全部挂在(event_id, version)的等待列表里。- hostDelay 6ms → Sgemm② 到达 stream0 队列:但 stream0 处于 stalled 状态,只能排队。


用 Ray Tune 内置的多种通用算法(CMA、OnePlusOne、PSO、TwoPointsDE、Random)对比 grid search(GPT3-2.7B 和 18.4B 两个场景):都在采样 200–300 个有效配置后收敛,比穷举省 60–75%。意义在于:Maya-Search 不依赖领域定制的搜索算法,通用黑盒优化器就够——Table 5 空间的”好配置区域”确实集中。
- 基线类
Grid(穷举):把 7 个 knob 的取值网格全部枚举(~1920 点)逐一评估。结果必然最优(在空间内),但成本线性于空间大小——它就是”无优化 >24h”的那个参照物。
Random(随机搜索):每次独立均匀采样。看似朴素,但在高维离散空间里是著名的强基线——好配置如果不稀疏,随机撞上的概率不低。Fig 16 里它也收敛,只是通常比进化类算法慢。
- 进化策略类(Evolution Strategies)
OnePlusOne(1+1 ES):最简单的进化策略——维持一个当前最优个体,每次对它做高斯变异产生一个后代,更好就替换,否则丢弃。本质上是带随机扰动的贪心爬山。优点是极度简单、收敛快;缺点是容易陷入局部最优。适合作为”搜索问题有没有局部结构”的试金石——它都能收敛,说明空间的优质区域是连片而非孤点。
CMA-ES(协方差矩阵自适应进化策略):正文§7.3选用的算法。维护一个多元高斯分布,每代从中采样一群候选,用表现好的候选同时更新均值和协方差矩阵——协方差自适应让它能学习”knob 之间的相关方向”(比如TP和microbatch数应该往哪个联合方向调),收敛方向和步长都自适应。对中小维度、非凸、带噪声的目标函数是默认强选择。
- 群体智能类
PSO(粒子群优化):一群”粒子”在空间里飞行,每个粒子的速度由三部分合成——惯性、飞向自己历史最优、飞向全局最优。粒子间通过信息共享实现群体收敛。在连续空间表现好,离散 knob 需要取整处理。
TwoPointsDE(两点交叉差分进化):差分进化(DE)的变体。新候选 = 基向量 + 缩放因子 × 种群中两个个体的差分向量,再与父代做两点交叉(两个切点之间的片段交换)。差分变异让步长自动随种群多样性收缩(前期探索、后期精调),是离散/混合空间上的稳健选择。
Fig 15 里那 20–30% 的 Skipped 是怎么来的——四条针对 Megatron-LM 的规则:
- 开 activation recomputation 都 OOM → 关掉它的同款配置必 OOM,直接跳过标记 OOM;
- 开 sequence parallelism 都 OOM → 同理跳过关闭版;
- 不开 distributed optimizer 都没 OOM → 开启版直接跳过(复用运行时);
- 无流水线并行时 n 个 microbatch 没 OOM → 增加 microbatch 的版本跳过(硬件利用率与 microbatch 数成反比,已知不会更优)。
很常见的剪枝规则构造,相信可以更加复杂一点。
Discuss
- GPU侧可以更换,但CPU开销固定在仿真机器上,如果端到端与CPU相关,无法避免CPU侧误差
- Maya,Alpa,FlexFlow这类并行搜索、DL编译器都假设Host控制流与计算结果完全解耦,一旦这一点被打破,例如MoE的路由规则,那么整体预测将失稳
- Maya没有涉及具体的GPU内资源管控问题,wait map 模型里,通信流和计算流是完全独立的资源。但真实硬件上,NCCL kernel 要占 SM、占 HBM 带宽、占 L2:与计算 kernel 并发时双方都会变慢。但这一点很难做,也只能做一个争抢模式的预测时长缩放,要准确只能牺牲模拟时间,很难接受。