Jev: cheapest and fastest structural model in 2026
从Gemini的规则化调用到AdaLLaVA,我一直想找到一个ms级别的决策模型。Jev的出现,似乎为这个梦想提供了可能。
传送门
发布blog Introducing System One Models & Jev 官方文档 docs.typesafe.ai 官方评测站 evals.typesafe.ai GitHub:typesafe-ai/system-one-adapter-python X 发布帖:@CompleteSkeptic 的公告 融资新闻稿:TypeSafe AI Emerges From Stealth With $40M(Business Wire) 试用入口:console.typesafe.ai
Overview
最近几天,网络被这样两张图刷屏
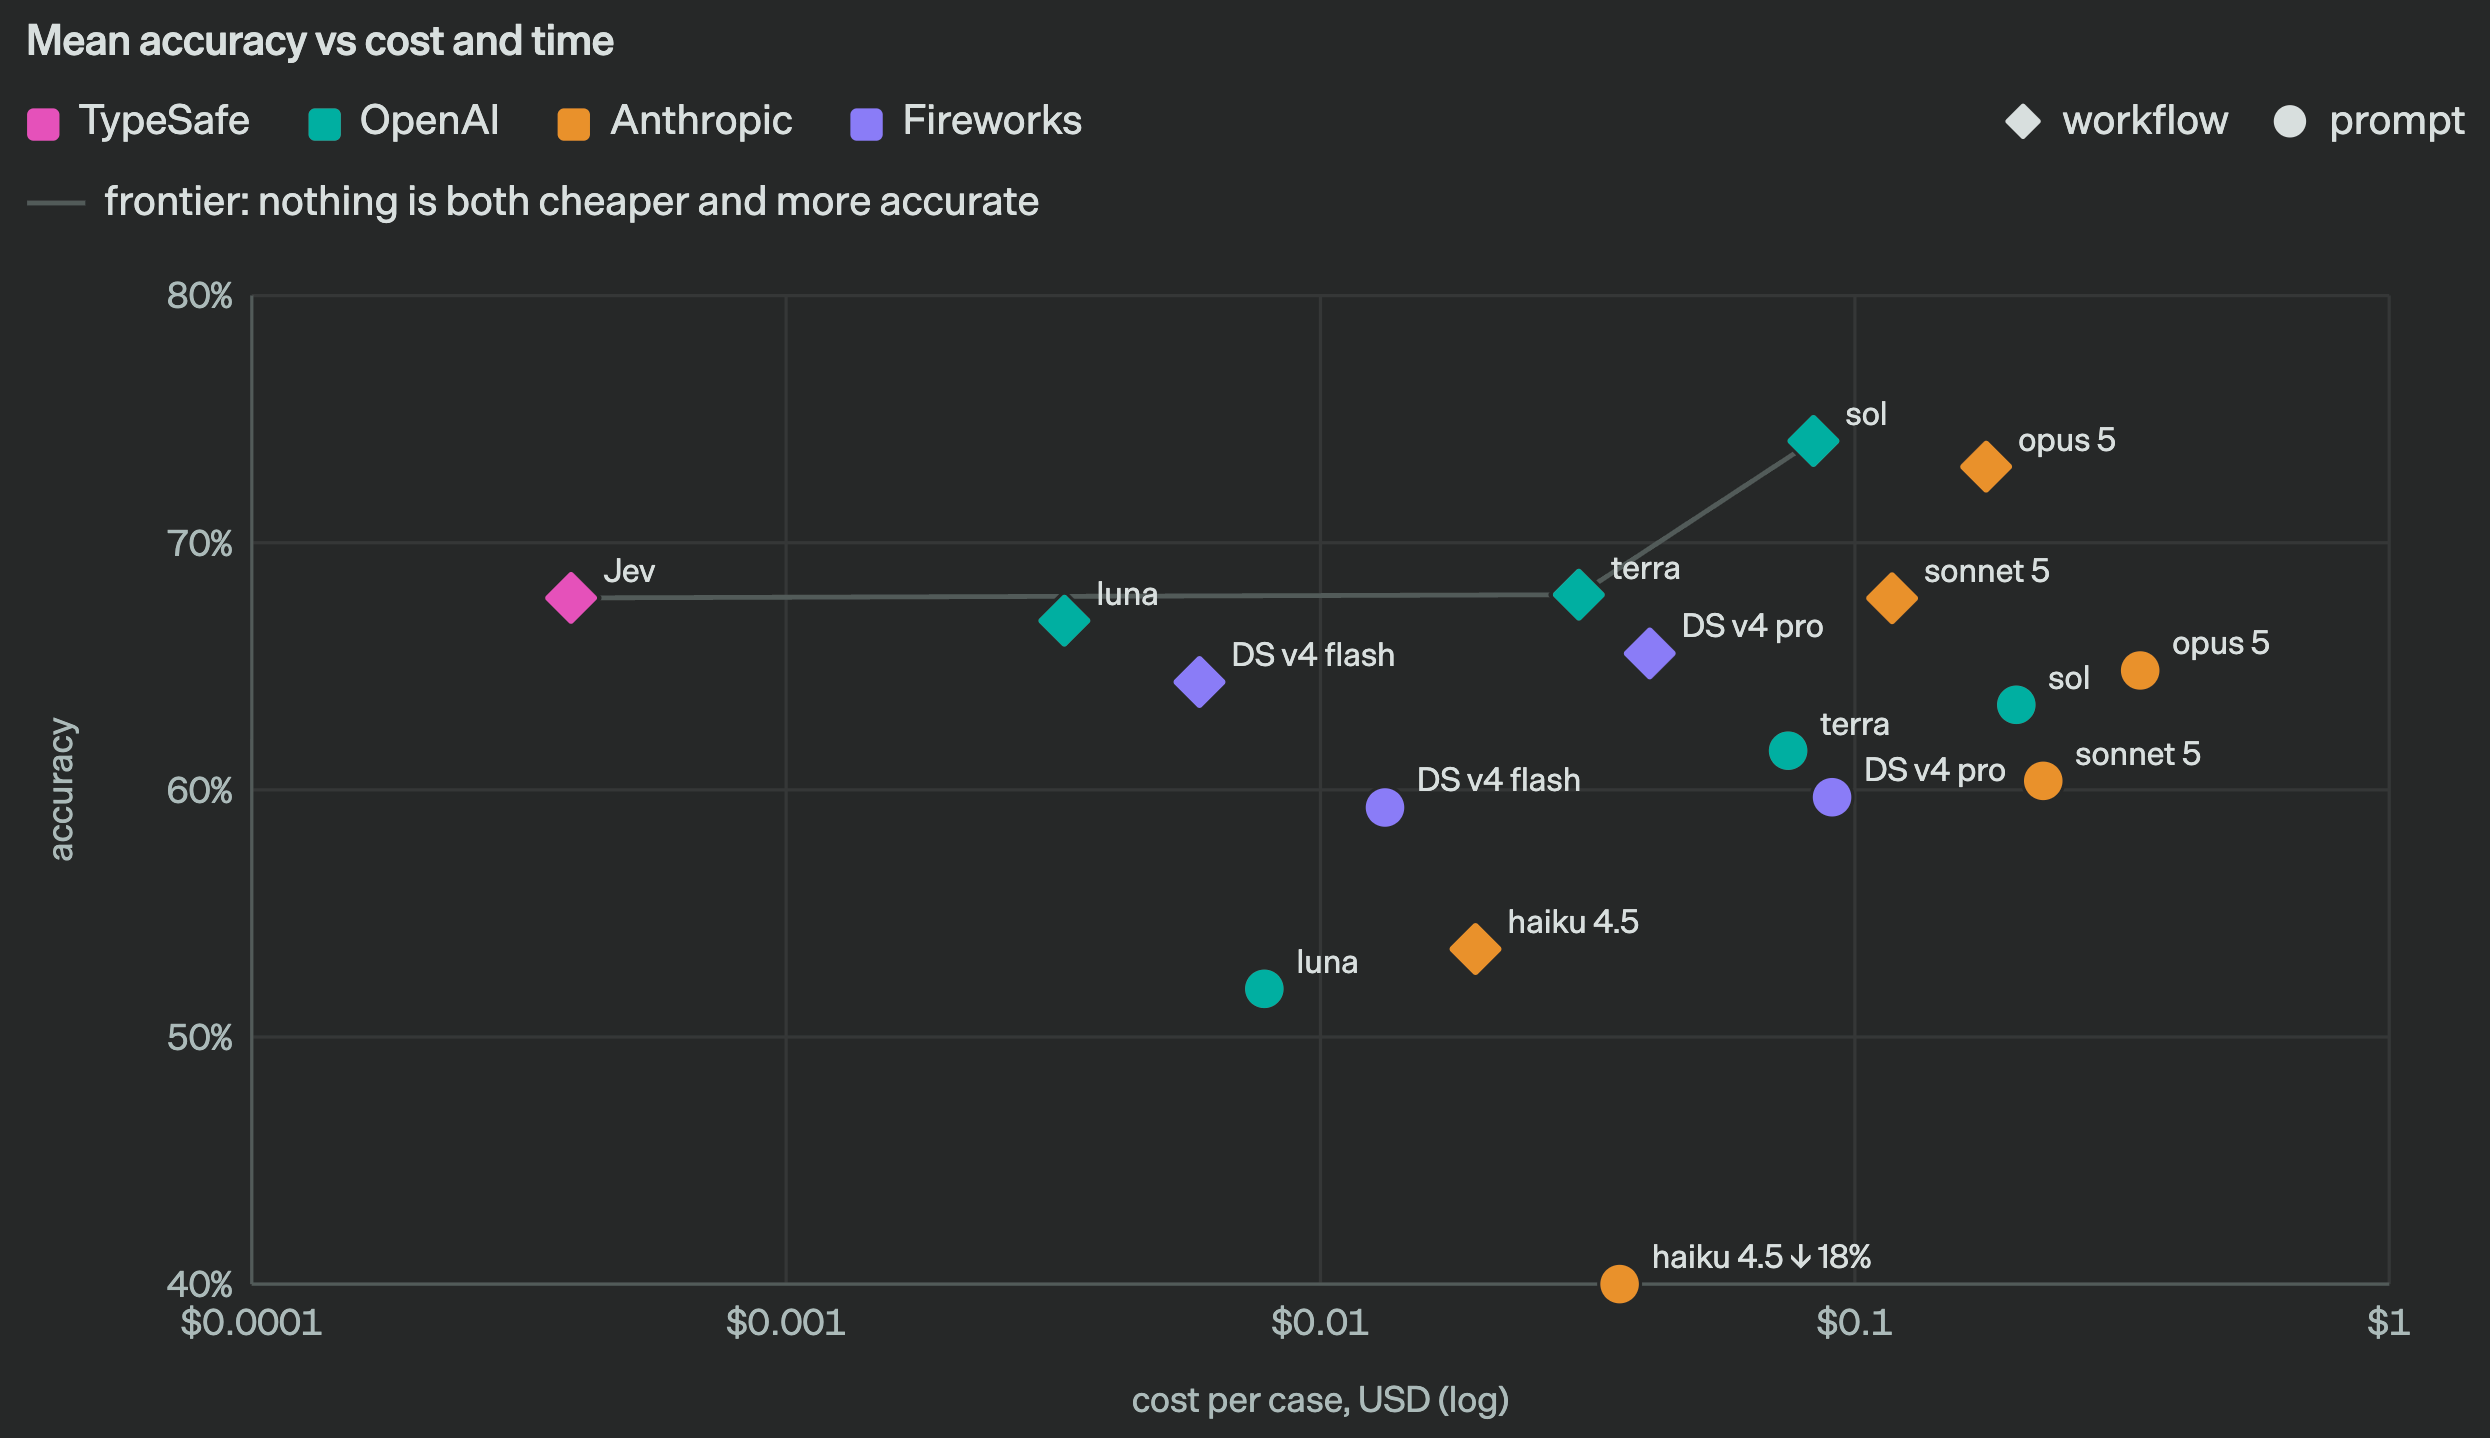
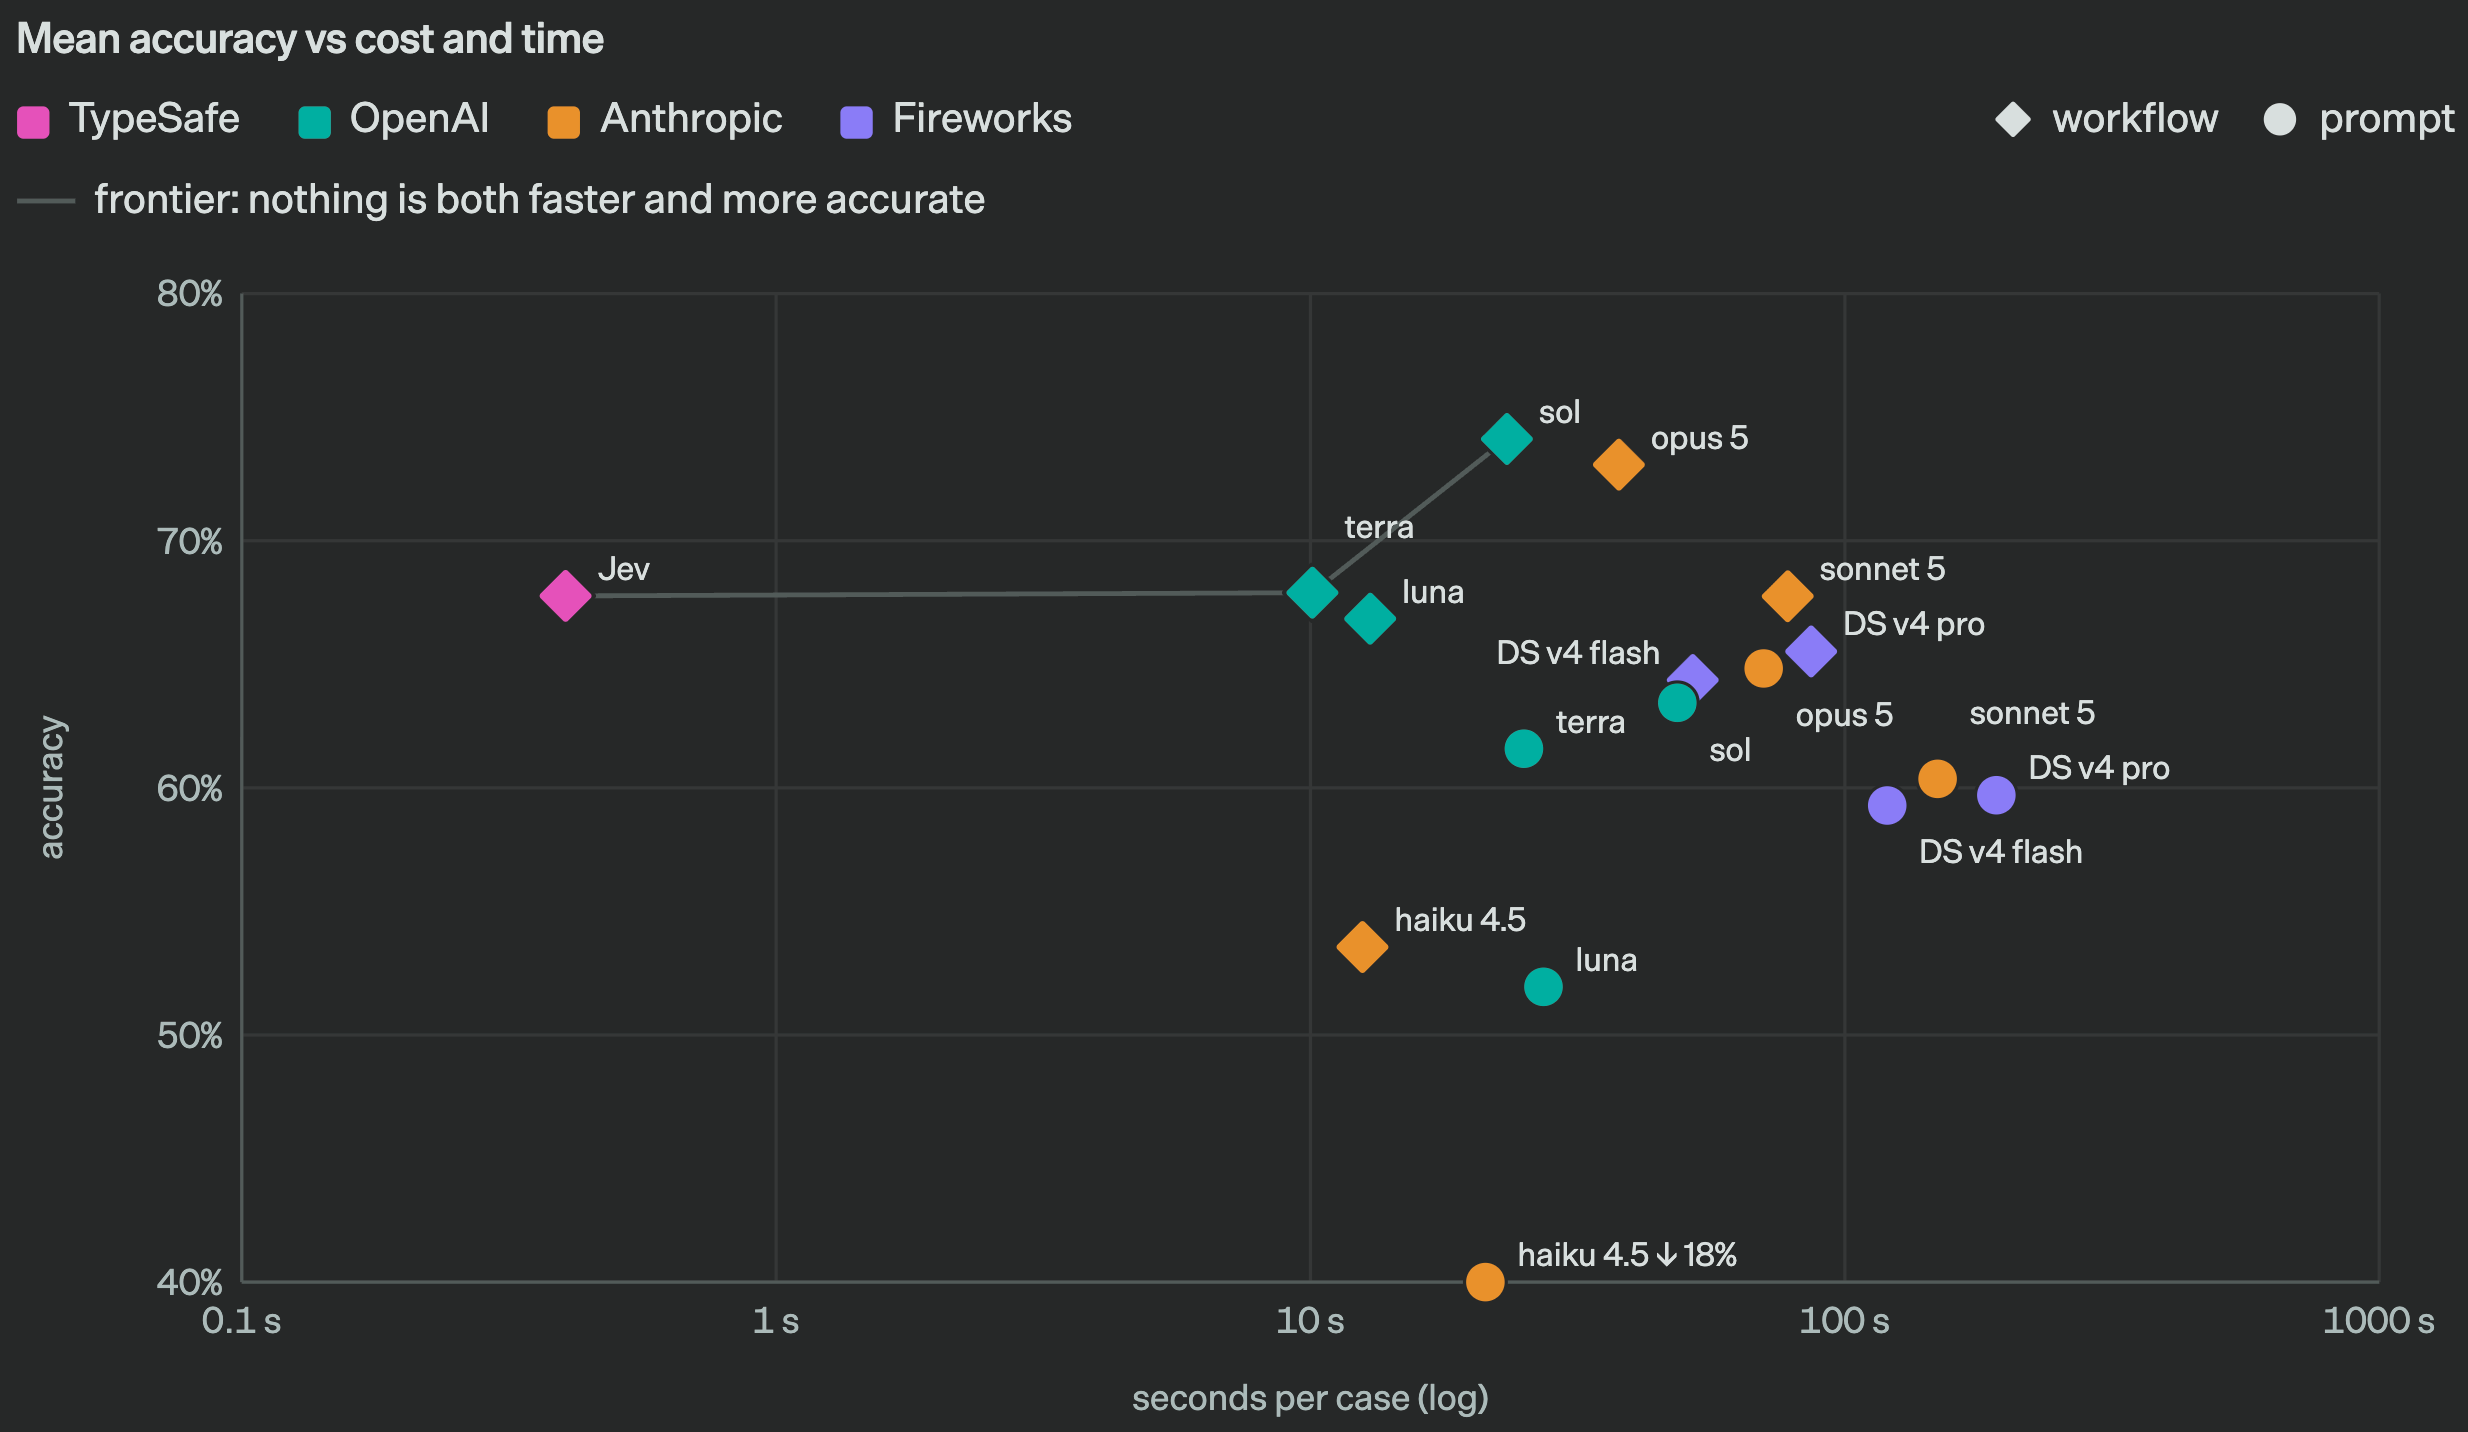
一个人工智能模型,能够做到保持terra级别的智力水平的同时,成本低于luna一个数量级,速度快于luna两个数量级。更加重要的是它宣传没有幻觉,对json有百分百的schema遵守。 进一步的看其输入是非结构化文本,输出是带校准概率的类型化决策。故事性爆炸。
令人遐想的故事包括:
- 筛选信息:包括数据库扩展,LLM上下文压缩,快速决策信息收集筛选(具身扩展)
- LLM配套:类似大小脑,做剪枝,做决策Harness(例如Router),做LLM的RL过程组件等
Jev的状态
Jev目前采用invite-only制度,在添加完waitlist后无任何官方模型调用渠道。
Jev的参数细节
- 版本:当前唯一版本是 jev-1.13.0,jev-latest 和 jev-preview 都指向它。(api调用元数据)
- 架构:“新架构加并行采样器”,非自回归。(官方声明),可能并没有自回归解码(decode不可能并行化)
- 参数:可能大于1B(基于Performance的猜测)
Performance
| 测试 | 任务 | Jev | 对照 | 延迟 |
|---|---|---|---|---|
| lindfors.no | 24 份挪威语听证文件,立场四分类 | 83% | DeepSeek 开推理 92%,不开 83% | 中位 0.32s |
| 韩语基准 | Belebele 韩 / 英 | 96 / 97 | 与 Luna 无显著差 | 中位 221ms |
| 同上 | PAWS-X 韩 / 英;韩国医考 | 76 / 80;80 | 医考上 Luna 高 8 分 | — |
| 钓鱼邮件基准 | 2,000 封邮件 | 准确率 62.6%,AUROC 0.689,ECE 0.154 | Haiku 4.5:81.3%,0.837,0.097 | p50 239ms |
| Laptop 复现 | 官方安全事件用例 | 76.9% | 本地 Qwen3-8B 同为 76.9%,Sol 88.5% | — |
社区观点
总体来讲社区观点偏向保守。认为其不是“性能等同terra的luna”,相反,这个架构采取了极端的trade off,比较准确受认可的描述是“基本就是个零样本分类器”。
主要批评集中于
- 针对case的展示存在误导,例如喂给模型的是坐标、角度这类结构化游戏状态,不是图像
- “frontier model”和”不会幻觉”的说法,存在夸大宣传的嫌疑
Related works
以下都基于官方留下的痕迹(例如GitHub 组织仓库)等痕迹猜测,可能不准
- 训练:RLCD。社区整理的技术谱系里,最接近的公开工作是 RLCR(arXiv 2507.16806,2025 年),它用 Brier 分数作奖励。
- LLaDA